16.3.9 日 php 面试总结,不定期更新。
3.9 - Sum up
Php
file_get_contents() 与 fopen()
fopen()-
fopen()打开网页后,返回的$fh不是字符串,不能直输出的,还需要用到fgets()这个函数来获取字符串。fgets()函数是从文件指针中读取一行(fgets(file, length = 1024))。 -
文件指针必须是有效的,必须指向由
fopen()或fsockopen()成功打开的文件(并还未由fclose()关闭)。可知,fopen()返回的只是一个资源,如果打开失败,本函数返回FALSE。 -
读取较大资源比较合适。
-
sample
$fh = fopen('http://www.baidu.com/', 'r');
if($fh){
	//feof() 函数检测是否已到达文件末尾 (eof)
    while(!feof($fh)) {
        echo fgets($fh);
    }
}
-
file_get_contents()-
直接返回字符串
-
自动关闭
-
sample
$fh = file_get_contents('http://www.baidu.com/'); echo $fh; -
other
//php 模拟 referer,cookie, 使用proxy
ini_set('default_socket_timeout',120);
ini_set('user_agent','MSIE 6.0;');
$context=array('http' => array ('header'=> 'Referer: http://www.baidu.com/', ),);
$xcontext = stream_context_create($context);
echo $str=file_get_contents('http://www.webkaka.com/',FALSE,$xcontext);
-
Redis / Memcached
redis 持久化存储
- one
在说Redis持久化之前,需要搞明白什么是数据库状态这个概念,因为持久化的就是将内存> 中的数据库状态保存到磁盘上。那么什么是数据库状态呢?Redis是一个key-value数据库服务器,一般默认是有16个数据库,可以使用select
命令进行切换(0-15),这每个非空的数据库又可以包含任意多个键值对,为了方便起见,我们将数据库服务器中的非空数据库以及它们的键值对通常为【数据库状态】,所以这里持久化,说的不是一个数据库,而是服务器上的所有非空数据库。 接着,我们继续来说redis的两种持久化方式,一种是RDB持久化,一种是AOF持久化,这两种持久化方式都可以将内存中的数据库状态保存到磁盘上,但是原理非常不同,我们逐一来看看,首先说一下RDB持久化。
RDB持久化默认生成的文件名为dump.rdb,这个可以通过配置文件配置,RDB文件一个经过压缩的二进制文件,接下来介绍一些rdb文件结构,RDB文件包含五个部分,分别是【Redis | db_version | databases | EOF | check_sum】开头的Redis表示这是一个RDB文件,服务器可以通过这个快速检查载入的文件是否是rdb文件,db_version是一个整数,代表RDB文件的版本,databases部分包含0个或者是任意多个数据库,以及数据库中的键值对数据,如果数据库状态是空,那么这部分也是空的,这部分的结构如下【SELECTDB | db_number | key_values_pairs】其中SELECTDB是一个常量,长度是一字节,当服务器遇到这个的时候,知道接下来要读入的将是一个数据库号码,db_number中保存的是一个数据库号码(0-15)这两部分结合就可以切换到相应的数据库,然后读取键值对了,键值对的部分的结构有两种,一种是带过期值的,一种是不带过期值的,如果是带过期值,那么结构是【EXPIRETIME_MS | ms | TYPE | key | value】第一个常量和SELECTDB一样,第二部分是毫秒为单位的UNIX时间戳,就是键值对的过期时间,然后是TYPE记录了value的类型,是String,list,set,zset,hash,等。不带过期值的键值对部分的结构没有前两部分,只是【TYPE | key | value】
RDB持久化可以通过命令进行手动执行,也可以配置好后让服务器自动执行,手动执行可以使用Redis命令【SAVE】或者【BGSAVE】,这两个命令有一些差别,需要说明一下,save命令会阻塞服务器进程,也就说,但save命令执行的时候服务器不能够处理任何命令请求,知道save命令执行完毕,RDB文件创建完毕,bgsave命令不会阻塞服务器,而是通过派生出一个子进程,然后由子进程负责创建RDB文件,服务器进程继续处理命令请求,这里需要说明一下,bgsave处理期间,服务器进程虽然能够继续处理命令请求,但是save,bgsave,bgrewriteaof这三个命令的处理方式会和平时有所不同,在bgsave期间,save命令会被服务器拒绝,服务器禁止save和bgsave同时执行,避免父进程和子进程同时执行两个rdbSave(创建RDB文件的实际工作实际上是由rdbSave函数完成,save和bgsave都会调用这个函数,只是调用的方式不同)调用,bgsave命令在bgsave期间也会被拒绝,理由和拒绝save的理由一样,两个bgsave也会产生竞争,bgrewriteaof命令会被延迟到bgsave执行完毕之后执行。
Redis没有专门的RDB文件载入命令,只要Redis服务器开启,就会检测RDB文件是否存在,就会自动载入RDB文件,这里需要说明一点,如果服务器开启了AOF持久化功能,服务器会优先使用AOF文件来还原数据库状态,只有在AOF持久化功能关闭的时候,才会使用RDB文件来还原数据库状态。
接下来说一下,RDB自动保存,前面已经说了,RDB可以通过手动执行,SAVE命令和BGSAVE命令,也可以通过配置让服务器自动执行,那么如何配置呢?
Redis.conf中可以配置,默认配置如下:
save 900 1 save 300 10 save 60 10000
以上表示的意思是,
900秒之内对服务进行了至少一次修改 300秒之内服务器进行了至少10次修改 60秒之内对服务器进行了至少10000次修改。 这些条件满足其中的任意一个bgsave命令就会自动执行。
那么你可能会好奇,服务器是怎么知道我做了多少修改的?服务器中有个dirty计数器和一个lastsave时间戳
当服务器执行一个数据库修改命令之后,dirty计数器就会进行更新,命令修改了多少次数据库,dirty就会增加多少,如:【set msg hello】修改了一个,那么dirty就加一,如果【mset msg word name nihao age 20】那么dirty就增加三
lastsave属性记录上次服务器执行保存操作的时间,是一个unix时间戳,通过这两个属性,可以很简单的距离上次保存已经多少时间了,以及修改了多少次数据库,一旦满足以上三个条件,那么就自动调用bgsave命令,同时更新lastsave属性和dirty属性归零。
至于检查保存条件是否满足这个工作,是由Redis服务器周期性操作函数serverCron默认间隔100毫秒执行一次检查,这个函数有很多地方用到,注意一下,这个函数是对正在运行的服务器进行维护的函数,在Redis事件中会有提到(Redis服务器是一个事件驱动程序,什么是事件驱动呢?就是发生事件的时候才会动一下,不然就跟死了一样,事件驱动又分为文件事件和时间事件,ServerCron就是一种时间驱动,至于文件驱动,其实就是客户端发过来一个命令,服务器才会去执行,然后给客户端返回结果)
最后说一点,Redis本身自带了一个RDB文件检查工具redis-check-dump,可以使用这个工具对rdb文件是否完整进行检查。
- another
Redis是一种高级key-value数据库。它跟memcached类似,不过数据可以持久化,而且支持的数据类型很丰富。有字符串,链表,集 合和有序集合。支持在服务器端计算集合的并,交和补集(difference)等,还支持多种排序功能。所以Redis也可以被看成是一个数据结构服务器。
Redis的所有数据都是保存在内存中,然后不定期的通过异步方式保存到磁盘上(这称为“半持久化模式”);也可以把每一次数据变化都写入到一个append only file(aof)里面(这称为“全持久化模式”)。
第一种方法filesnapshotting:默认redis是会以快照的形式将数据持久化到磁盘的(一个二进 制文件,dump.rdb,这个文件名字可以指定),在配置文件中的格式是:save N M表示在N秒之内,redis至少发生M次修改则redis抓快照到磁盘。当然我们也可以手动执行save或者bgsave(异步)做快照。
工作原理简单介绍一下:当redis需要做持久化时,redis会fork一个子进程;子进程将数据写到磁盘上一个临时RDB文件中;当子进程完成写临时文件后,将原来的RDB替换掉,这样的好处就是可以copy-on-write,
还有一种持久化方法是Append-only:filesnapshotting方法在redis异常死掉时, 最近的数据会丢失(丢失数据的多少视你save策略的配置),所以这是它最大的缺点,当业务量很大时,丢失的数据是很多的。Append-only方法可 以做到全部数据不丢失,但redis的性能就要差些。
AOF就可以做到全程持久化,只需要在配置文件中开启(默认是no),appendonly yes开启AOF之后,redis每执行一个修改数据的命令,都会把它添加到aof文件中,当redis重启时,将会读取AOF文件进行“重放”以恢复到 redis关闭前的最后时刻。
LOG Rewriting随着修改数据的执行AOF文件会越来越大,其中很多内容记录某一个key的变化情况。
因此redis有了一种比较有意思的特性:在后台重建AOF文件,而不会影响client端操作。在任何时候执行BGREWRITEAOF命令,都会把当前内存中最短序列的命令写到磁盘,这些命令可以完全构建当前的数据情况,而不会存在多余的变化情况(比如状态变化,计数器变化等),缩小的AOF文件的大小。
所以当使用AOF时,redis推荐同时使用BGREWRITEAOF。
AOF文件刷新的方式,有三种,参考配置参数appendfsync :appendfsync always每提交一个修改命令都调用fsync刷新到AOF文件,非常非常慢,但也非常安全;appendfsync everysec每秒钟都调用fsync刷新到AOF文件,很快,但可能会丢失一秒以内的数据;appendfsync no依靠OS进行刷新,redis不主动刷新AOF,这样最快,但安全性就差。默认并推荐每秒刷新,这样在速度和安全上都做到了兼顾。
可能由于系统原因导致了AOF损坏,redis无法再加载这个AOF,可以按照下面步骤来修复:首先做一个AOF文件的备份,复制到其他地方;修复原始AOF文件,执行:$ redis-check-aof –fix ;可以通过diff –u命令来查看修复前后文件不一致的地方;重启redis服务。
LOG Rewrite的工作原理:同样用到了copy-on-write:首先redis会fork一个子进程;子进程将最新的AOF写入一个临时文件;父进程 增量的把内存中的最新执行的修改写入(这时仍写入旧的AOF,rewrite如果失败也是安全的);当子进程完成rewrite临时文件后,父进程会收到 一个信号,并把之前内存中增量的修改写入临时文件末尾;这时redis将旧AOF文件重命名,临时文件重命名,开始向新的AOF中写入。
最后,为以防万一(机器坏掉或磁盘坏掉),记得定期把使用 filesnapshotting 或 Append-only 生成的*rdb *.aof文件备份到远程机器上。我是用crontab每半小时SCP一次。我没有使用redis的主从功能 ,因为半小时备份一次应该是可以了,而且我觉得有如果做主从有点浪费机器。这个最终还是看应用来定了。
========================
数据持久化通俗讲就是把数据保存到磁盘上,保证不会因为断电等因素丢失数据。
redis 需要经常将内存中的数据同步到磁盘来保证持久化。redis支持两种持久化方式,一种是 Snapshotting(快照)也是默认方式,另一种是Append-only file(缩写aof)的方式。先介绍下这两种dump方式再讲讲自己遇到的一些现象和想法,前面的内容是从网上整理出来的。
Snapshotting
快照是默认的持久化方式。这种方式是就是将内存中数据以快照的方式写入到二进制文件中,默认的文件名为dump.rdb。可以通过配置设置自动做快照持久 化的方式。
我们可以配置redis在n秒内如果超过m个key被修改就自动做快照,下面是默认的快照保存配置
save 900 1 #900秒内如果超过1个key被修改,则发起快照保存
save 300 10 #300秒内容如超过10个key被修改,则发起快照保存
save 60 10000
下面介绍详细的快照保存过程
1.redis调用fork,现在有了子进程和父进程。
- 父进程继续处理client请求,子进程负责将内存内容写入到临时文件。由于os的写时复制机制(copy on write)父子进程会共享相同的物理页面,当父进程处理写请求时os会为父进程要修改的页面创建副本,而不是写共享的页面。所以子进程的地址空间内的数 据是fork时刻整个数据库的一个快照。
3.当子进程将快照写入临时文件完毕后,用临时文件替换原来的快照文件,然后子进程退出。
client 也可以使用save或者bgsave命令通知redis做一次快照持久化。save操作是在主线程中保存快照的,由于redis是用一个主线程来处理所有 client的请求,这种方式会阻塞所有client请求。所以不推荐使用。另一点需要注意的是,每次快照持久化都是将内存数据完整写入到磁盘一次,并不 是增量的只同步脏数据。如果数据量大的话,而且写操作比较多,必然会引起大量的磁盘io操作,可能会严重影响性能。
另外由于快照方式是在一定间隔时间做一次的,所以如果redis意外down掉的话,就会丢失最后一次快照后的所有修改。如果应用要求不能丢失任何修改的话,可以采用aof持久化方式。
下面介绍 Append-only file
aof 比快照方式有更好的持久化性,是由于在使用aof持久化方式时,redis会将每一个收到的写命令都通过write函数追加到文件中(默认是 appendonly.aof)。当redis重启时会通过重新执行文件中保存的写命令来在内存中重建整个数据库的内容。当然由于os会在内核中缓存 write做的修改,所以可能不是立即写到磁盘上。这样aof方式的持久化也还是有可能会丢失部分修改。不过我们可以通过配置文件告诉redis我们想要 通过fsync函数强制os写入到磁盘的时机。
有三种方式如下(默认是:每秒fsync一次)
appendonly yes //启用aof持久化方式
appendfsync always //每次收到写命令就立即强制写入磁盘,最慢的,但是保证完全的持久化,不推荐使用
appendfsync everysec //每秒钟强制写入磁盘一次,在性能和持久化方面做了很好的折中,推荐
appendfsync no //完全依赖os,性能最好,持久化没保证
aof 的方式也同时带来了另一个问题。持久化文件会变的越来越大。例如我们调用incr test命令100次,文件中必须保存全部的100条命令,其实有99条都是多余的。因为要恢复数据库的状态其实文件中保存一条set test 100就够了。
为了压缩aof的持久化文件。redis提供了bgrewriteaof命令。收到此命令redis将使用与快照类似的方式将内存中的数据 以命令的方式保存到临时文件中,最后替换原来的文件。具体过程如下
redis调用fork ,现在有父子两个进程
子进程根据内存中的数据库快照,往临时文件中写入重建数据库状态的命令
3.父进程继续处理client请求,除了把写命令写入到原来的aof文件中。同时把收到的写命令缓存起来。这样就能保证如果子进程重写失败的话并不会出问题。
4.当子进程把快照内容写入已命令方式写到临时文件中后,子进程发信号通知父进程。然后父进程把缓存的写命令也写入到临时文件。
5.现在父进程可以使用临时文件替换老的aof文件,并重命名,后面收到的写命令也开始往新的aof文件中追加。
需要注意到是重写aof文件的操作,并没有读取旧的aof文件,而是将整个内存中的数据库内容用命令的方式重写了一个新的aof文件,这点和快照有点类似。
运维上的想法
其实快照和aof一样,都使用了Copy-on-write技术。多次试验发现每次做数据dump的时候,内存都会扩大一倍(关于这个问题可以参考我去年写的redis的内存陷阱,很多人用redis做为缓存,数据量小,dump耗时非常短暂,所以不太容易发现),这个时候会有三种情况:
一:物理内存足以满足,这个时候dump非常快,性能最好
二:物理内存+虚拟内存可以满足,这个时候dump速度会比较慢,磁盘swap繁忙,服务性能也会下降。所幸的是经过一段比较长的时候数据dump完成了,然后内存恢复正常。这个情况系统稳定性差。
三: 物理内存+虚拟内存不能满足,这个时候dump一直死着,时间久了机器挂掉。这个情况就是灾难!
如果数据要做持久化又想保证稳定性,建议留空一半的物理内存。如果觉得无法接受还是有办法,下面讲:
快照和aof虽然都使用Copy-on-write,但有个不同点,快照你无法预测redis什么时候做dump,aof可以通过bgrewriteaof命令控制dump的时机。
根据这点我可以在一个服务器上开启多个redis节点(利用多CPU),使用aof的持久化方式。
例 如在24G内存的服务器上开启3个节点,每天用bgrewriteaof定期重新整理数据,每个节点dump的时间都不一样,这 样理论上每个节点可以消耗6G内存,一共使用18G内存,另外6G内存在单个节点dump时用到,内存一下多利用了6G! 当然节点开的越多内存的利用率也越高。如果带宽不是问题,节点数建议 = CPU数。
我的应用里为了保证高性能,数据没有做dump,也没有用aof。因为不做dump发生的故障远远低于做dump的时候,即使数据丢失了,自动修复脚本可以马上数据恢复。毕竟对海量数据redis只能做数据分片,那么落到每个节点上的数据量也不会很多。
redis的虚拟内存建议也不要用,用redis本来就是为了达到变态的性能,虚拟内存、aof看起来都有些鸡肋。
现在还离不开redis,因为它的mget是现在所有db里性能最好的,以前也考虑过用tokyocabinet hash方式做mget,性能不给力。直接用redis,基本上单个redis节点mget可以达到10W/s
纠错
之前说过redis做数据dump的时候内容会扩大一倍,后来我又做了些测试,发现有些地方说的不对。
top 命令并不是反映真实的内存占用情况,在top里尽管fork出来的子进程占了和父进程一样的内存,但是当做dump的时候没有写操作,实际使 用的是同一份内存的数据。当有写操作的时候内存才会真实的扩大(具体是不是真实的扩大一倍不确定,可能数据是按照页分片的),这才是真正的Copy- on-write。
基于这点在做数据持久化会更加灵活。
redis 共享
- 如何实现 redis 共享(集群)
redis 数据结构类型
-
分别有哪几种
String——字符串 Hash——字典 List——列表 Set——集合 Sorted Set——有序集合 -
各有什么优缺点
-
String——字符串
-
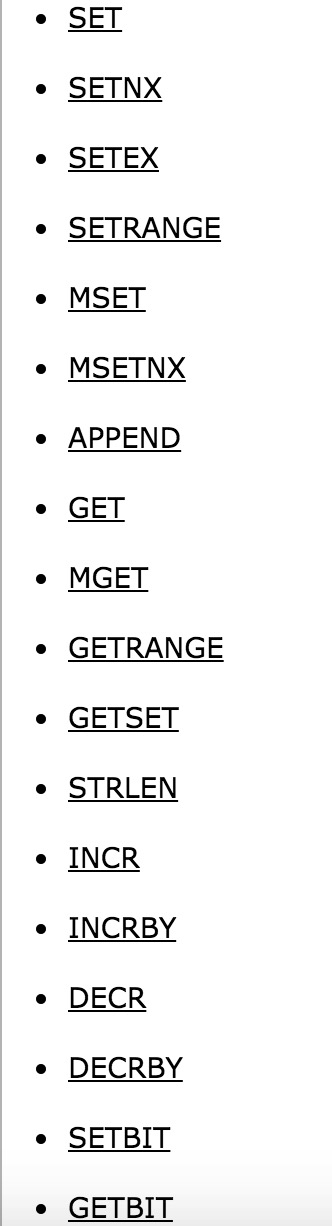
String 数据结构是简单的 key-value 类型,value 不仅可以是 String,也可以是数字(当数字类型用 Long 可以表示的时候encoding 就是整型,其他都存储在 sdshdr 当做字符串)。使用 Strings 类型,可以完全实现目前 Memcached 的功能,并且效率更高。还可以享受 Redis 的定时持久化(可以选择 RDB 模式或者 AOF 模式),操作日志及 Replication 等功能。除了提供与 Memcached 一样的 get、set、incr、decr 等操作外,Redis 还提供了下面一些操作:
1.LEN niushuai:O(1)获取字符串长度 2.APPEND niushuai redis:往字符串 append 内容,而且采用智能分配内存(每次2倍) 3.设置和获取字符串的某一段内容 4.设置及获取字符串的某一位(bit) 5.批量设置一系列字符串的内容 6.原子计数器 7.GETSET 命令的妙用,请于清空旧值的同时设置一个新值,配合原子计数器使用 -
actions
-
-
Hash——字典
-
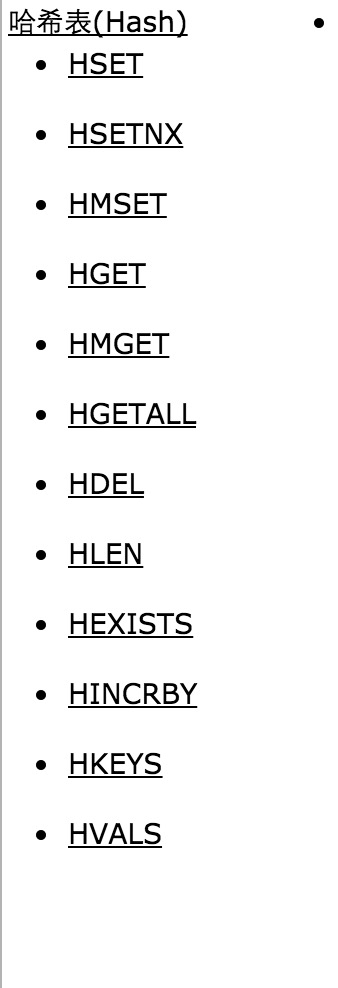
在 Memcached 中,我们经常将一些结构化的信息打包成 hashmap,在客户端序列化后存储为一个字符串的值(一般是 JSON 格式),比如用户的昵称、年龄、性别、积分等。这时候在需要修改其中某一项时,通常需要将字符串(JSON)取出来,然后进行反序列化,修改某一项的值,再序列化成字符串(JSON)存储回去。简单修改一个属性就干这么多事情,消耗必定是很大的,也不适用于一些可能并发操作的场合(比如两个并发的操作都需要修改积分)。而 Redis 的 Hash 结构可以使你像在数据库中 Update 一个属性一样只修改某一项属性值。
存储、读取、修改用户属性 -
actions
-
-
List——列表
-
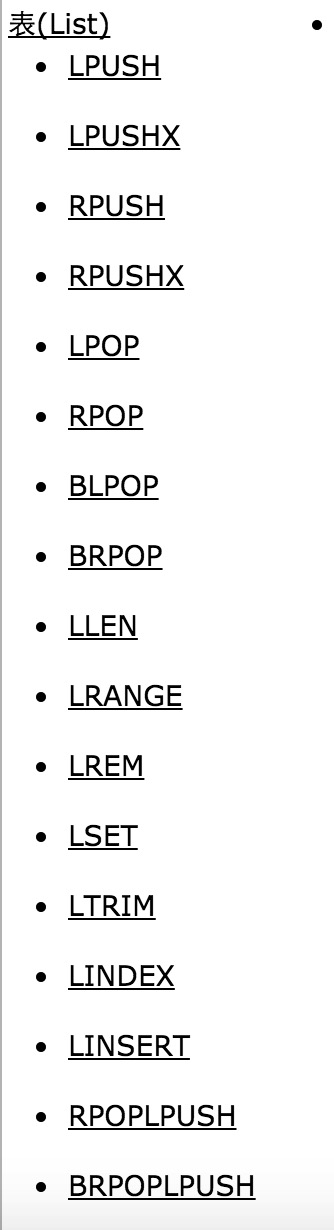
List 说白了就是链表(redis 使用双端链表实现的 List),相信学过数据结构知识的人都应该能理解其结构。使用 List 结构,我们可以轻松地实现最新消息排行等功能(比如新浪微博的 TimeLine )。List 的另一个应用就是消息队列,可以利用 List 的 *PUSH 操作,将任务存在 List 中,然后工作线程再用 POP 操作将任务取出进行执行。Redis 还提供了操作 List 中某一段元素的 API,你可以直接查询,删除 List 中某一段的元素。
1.微博 TimeLine 2.消息队列 -
actions
-
-
Set——集合
-
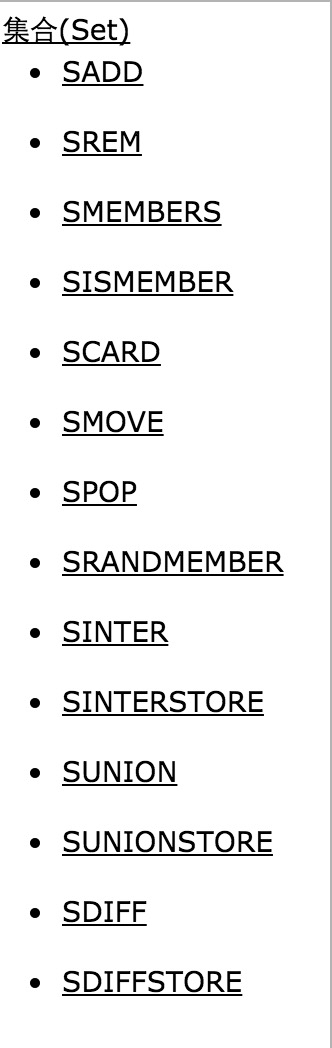
Set 就是一个集合,集合的概念就是一堆不重复值的组合。利用 Redis 提供的 Set 数据结构,可以存储一些集合性的数据。比如在微博应用中,可以将一个用户所有的关注人存在一个集合中,将其所有粉丝存在一个集合。因为 Redis 非常人性化的为集合提供了求交集、并集、差集等操作,那么就可以非常方便的实现如共同关注、共同喜好、二度好友等功能,对上面的所有集合操作,你还可以使用不同的命令选择将结果返回给客户端还是存集到一个新的集合中。
1.共同好友、二度好友 2.利用唯一性,可以统计访问网站的所有独立 IP 3.好友推荐的时候,根据 tag 求交集,大于某个 threshold 就可以推荐 -
actions
-
-
Sorted Set——有序集合
-
和Sets相比,Sorted Sets是将 Set 中的元素增加了一个权重参数 score,使得集合中的元素能够按 score 进行有序排列,比如一个存储全班同学成绩的 Sorted Sets,其集合 value 可以是同学的学号,而 score 就可以是其考试得分,这样在数据插入集合的时候,就已经进行了天然的排序。另外还可以用 Sorted Sets 来做带权重的队列,比如普通消息的 score 为1,重要消息的 score 为2,然后工作线程可以选择按 score 的倒序来获取工作任务。让重要的任务优先执行。
1.带有权重的元素,比如一个游戏的用户得分排行榜 2.比较复杂的数据结构,一般用到的场景不算太多 -
actions
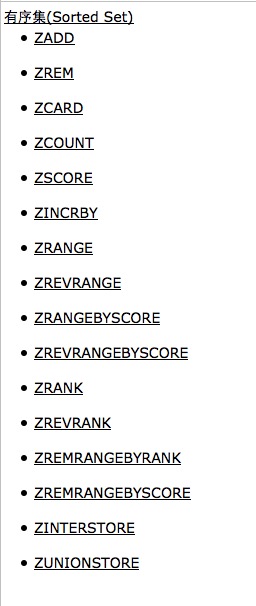
-
-
订阅-发布系统
-
Pub/Sub 从字面上理解就是发布(Publish)与订阅(Subscribe),在 Redis 中,你可以设定对某一个 key 值进行消息发布及消息订阅,当一个 key 值上进行了消息发布后,所有订阅它的客户端都会收到相应的消息。这一功能最明显的用法就是用作实时消息系统,比如普通的即时聊天,群聊等功能。
-
actions
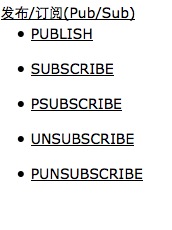
-
-
事务——Transactions
-
谁说 NoSQL 都不支持事务,虽然 Redis 的 Transactions 提供的并不是严格的 ACID 的事务(比如一串用 EXEC 提交执行的命令,在执行中服务器宕机,那么会有一部分命令执行了,剩下的没执行),但是这个 Transactions 还是提供了基本的命令打包执行的功能(在服务器不出问题的情况下,可以保证一连串的命令是顺序在一起执行的,中间有会有其它客户端命令插进来执行)。Redis 还提供了一个 Watch 功能,你可以对一个 key 进行 Watch,然后再执行 Transactions,在这过程中,如果这个 Watched 的值进行了修改,那么这个 Transactions 会发现并拒绝执行。
-
actions 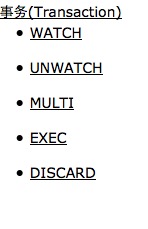
-
-
连接(Connection)
- actions 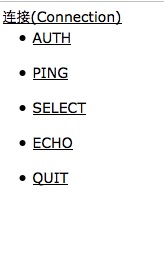
-
服务器(Server)
- actions 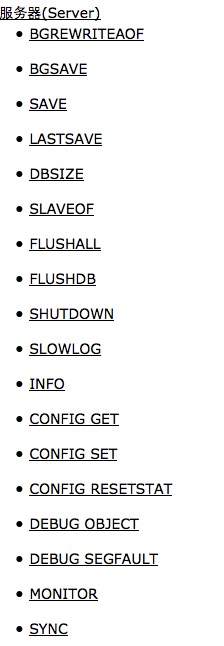
-
memcached 最大存储数据、最长存储时间
-
最大存储数据(key 的长度小于250字符, value 小于 1mb)
Memcached存储单个item最大数据是在1MB内,假设数据超过1M,存取set和get是都是返回false,并且引起性能的问题。
我们之前对排行榜的数据进行缓存,因为排行榜在我们全部sql select查询里面占了30%,并且我们排行榜每小时更新一次,所以必须对数据做缓存。为了清除缓存方便,把全部的用户的数据放在同一key中,因为memcached:set的时候没有压缩数据。在測试服測试的时候,没发现问题,当上线的时候,结果发现,在线人数刚刚490人的时候,serverload average飘到7.9。然后我们去掉缓存,一下子就下降到0.59。
所以Memcahce不适合缓存大数据,超过 1MB的数据 ,能够考虑在client压缩或拆分到多个 key 中。大的数据在进行load和uppack到内存的时候须要花非常长时间,从而减少server的性能。
Memcached 支持最大的存储对象为 1M 。这个值由其内存分配机制决定的。
memcached 默认情况下採用了名为 Slab Allocator 的机制分配、管理内存。在该机制出现曾经,内存的分配是通过对全部记录简单地进行 malloc 和 free 来进行的。可是,这样的方式会导致内存碎片,加重操作系统内存管理器的负担,最坏的情况下,会导致操作系统比 memcached 进程本身还慢。 Slab Allocator 就是为解决该问题而诞生的。 Slab Allocator 的基本原理是依照预先规定的大小,将分配的内存切割成特定长度的块,以全然解决内存碎片问题.
今天(2012-03-16)我们又一次測试了memcached ::set的数据大小。可能是我们用php的memcached扩展是最新版,set数据的时候是默认压缩的。set 数据:
$ac = new memcahed(); $data = str_repeat(‘a’, 1024* 1024); //1M的数据 $r = $ac->set(‘key’, $data, 9999); //或者 $data = str_repeat(‘a’, 1024* 1024*100);//100M的数据 $r = $ac->set(‘key’, $data, 9999);
不论是1M的数据还是100M的数据,都能set成功。后来我发现,memcached set数据的时候是默认压缩的。因为这个这个是反复的字符串,压缩率高达1000倍。因此100M的数据压缩后实际也就100k而已。当我设置:
$ac->setOption(memcahed::OPT_COMPRESSION,0); //不压缩存储数据。 $data = str_repeat(‘a’, 1024* 1024); //1M数据 $r = $ac->set(‘key’, $data, 9999);//1M的数据set不成功。
也就是说memcached server不能存储超过1M的数据,可是 经过 client压缩数据后,仅仅要小于1M的数据都能存储成功。memcached相关知识:
1、memcached的基本设置
/usr/local/bin/memcached -d -m 10 -u root -l 192.168.0.200 -p 12000 -c 256 -P /tmp/memcached.pid-d选项是启动一个守护进程,
-m是分配给Memcache使用的内存数量,单位是MB,我这里是10MB,
-u是执行Memcache的用户,我这里是root,
-l是监听的serverIP地址,假设有多个地址的话,我这里指定了server的IP地址192.168.0.200,
-p是设置Memcache监听的port,我这里设置了12000,最好是1024以上的port,
-c选项是最大执行的并发连接数,默认是1024,我这里设置了256,依照你server的负载量来设定,
-P是设置保存Memcache的pid文件,我这里是保存在 /tmp/memcached.pid,
2)假设要结束Memcache进程,运行:
kill 'cat /tmp/memcached.pid'哈希算法 将 随意长度的二进制值映射为固定长度的较小二进制值,这个小的二进制值称为哈希值。哈希值是一段数据唯一且极其紧凑的数值表示形式。假设散列一段明文并且哪怕仅仅更改该
段落的一个字母,随后的哈希都将产生不同的值。要找到散列为同一个值的两个不同的输入,在计算上是不可能的。
2、适用memcached的业务场景?
1)假设站点包括了訪问量非常大的动态网页,因而数据库的负载将会非常高。因为大部分数据库请求都是读操作,那么memcached能够显著地减小数据库负载。
2)假设数据库server的负载比較低但CPU使用率非常高,这时能够缓存计算好的结果( computed objects )和渲染后的网页模板(enderred templates)。
3)利用memcached能够缓存 session数据 、暂时数据以降低对他们的数据库写操作。
4)缓存一些非常小可是被频繁訪问的文件。
5)缓存Web ‘services’(非IBM宣扬的Web Services,译者注)或RSS feeds的结果.。
3、不适用memcached的业务场景?
1)缓存对象的大小大于1MB
Memcached本身就不是为了处理庞大的多媒体(large media)和巨大的二进制块(streaming huge blobs)而设计的。
2)key的长度大于250字符
3)虚拟主机不让执行memcached服务
假设应用本身托管在低端的虚拟私有server上,像vmware, xen这类虚拟化技术并不适合执行memcached。Memcached须要接管和控制大块的内存,假设memcached管理 的内存被OS或 hypervisor交换出去,memcached的性能将大打折扣。
4)应用执行在不安全的环境中
Memcached为提供不论什么安全策略,只通过telnet就能够訪问到memcached。假设应用执行在共享的系统上,须要着重考虑安全问题。
5)业务本身须要的是持久化数据或者说须要的应该是database
4、 不能可以遍历memcached中全部的item
这个操作的速度相对缓慢且堵塞其它的操作(这里的缓慢时相比memcached其它的命令)。memcached全部非调试(non-debug)命令,比如add, set, get, fulsh等不管
memcached中存储了多少数据,它们的运行都仅仅消耗常量时间。不论什么遍历全部item的命令运行所消耗的时间,将随着memcached中数据量的添加而添加。当其它命令由于等待(遍历全部item的命令运行完成)而不能得到运行,因而堵塞将发生。
5、 memcached能接受的key的最大长度是250个字符 memcached能接受的key的最大长度是250个字符。须要注意的是,250是memcachedserver端内部的限制。假设使用的Memcachedclient支持“key的前缀”或类似特性,那么key(前缀+原始key)的最大长度是能够超过250个字符的。推荐使用较短的key,这样能够节省内存和带宽。
6、 单个item的大小被限制在1M byte之内 由于内存分配器的算法就是这种。
具体的回答:
1)Memcached的内存存储引擎,使用slabs来管理内存。内存被分成大小不等的slabs chunks(先分成大小相等的slabs,然后每一个slab被分成大小相等chunks,不同slab的chunk大小是不相等的)。chunk的大小依次从一个最小数開始,按某个因子增长,直到达到最大的可能值。假设最小值为400B,最大值是1MB,因子是1.20,各个slab的chunk的大小依次是:
slab1 - 400B;slab2 - 480B;slab3 - 576B …slab中chunk越大,它和前面的slab之间的间隙就越大。因此,最大值越大,内存利用率越低。Memcached必须为每一个slab预先分配内存,因此假设设置了较小的因子和较大的最大值,会须要为Memcached提供很多其它的内存。
2)不要尝试向memcached中存取非常大的数据,比如把巨大的网页放到mencached中。由于将大数据load和unpack到内存中须要花费非常长的时间,从而导致系统的性能反而不好。假设确实须要存储大于1MB的数据,能够改动slabs.c:POWER_BLOCK的值,然后又一次编译memcached;或者使用低效的malloc/free。另外,能够使用数据库、MogileFS等方案取代Memcached系统。
7、 memcached的内存分配器是怎样工作的?为什么不适用malloc/free!?为何要使用slabs? 实际上,这是一个编译时选项。默认会使用内部的slab分配器,并且确实应该使用内建的slab分配器。最早的时候,memcached仅仅使用malloc/free来管理内存。然而,这样的方式不能与OS的内存管理曾经非常好地工作。重复地malloc/free造成了内存碎片,OS终于花费大量的时间去查找连续的内存块来满足malloc的请求,而不是执行memcached进程。slab分配器就是为了解决问题而生的。内存被分配并划分成chunks,一直被重复使用。由于内存被划分成大小不等的slabs,假设item的大小与被选择存放它的slab不是非常合适的话,就会浪费一些内存。
8、memcached对item的过期时间有什么限制?
item对象的过期时间最长能够达到30天。memcached把传入的过期时间(时间段)解释成时间点后,一旦到了这个时间点,memcached就把item置为失效状态,这是一个简单但obscure的机制。
9、什么是二进制协议,是否须要关注?
二进制协议尝试为端提供一个更有效的、可靠的协议,降低client/server端因处理协议而产生的CPU时间。依据Facebook的測试,解析ASCII协议是memcached中消耗CPU时间最多的环节。
10、 memcached的内存分配器是怎样工作的?为什么不适用malloc/free!?为何要使用slabs?
实际上,这是一个编译时选项。默认会使用内部的slab分配器,并且确实应该使用内建的slab分配器。最早的时候,memcached仅仅使用malloc/free来管理内存。然而,这样的方式不能与OS的内存管理曾经非常好地工作。重复地malloc/free造成了内存碎片,OS终于花费大量的时间去查找连续的内存块来满足malloc的请求,而不是执行memcached进程。slab分配器就是为了解决问题而生的。内存被分配并划分成chunks,一直被重复使用。由于内存被划分成大小不等的slabs,假设item的大小与被选择存放它的slab不是非常合适的话,就会浪费一些内存。
11、memcached是原子的吗?
全部的被发送到memcached的单个命令是全然原子的。假设您针对同一份数据同一时候发送了一个set命令和一个get命令,它们不会影响对方。它们将被串行化、先后运行。即使在多线程模式,全部的命令都是原子的。然是,命令序列不是原子的。假设首先通过get命令获取了一个item,改动了它,然后再把它set回memcached,系统不保证这个item没有被其它进程(process,未必是操作系统中的进程)操作过。memcached 1.2.5以及更高版本号,提供了gets和cas命令,它们能够解决上面的问题。假设使用gets命令查询某个key的item,memcached会返回该item当前值的唯一标识。假设client程序覆写了这个item并想把它写回到memcached中,能够通过cas命令把那个唯一标识一起发送给memcached。假设该item存放在memcached中的唯一标识与您提供的一致,写操作将会成功。假设还有一个进程在这期间也改动了这个item,那么该item存放在memcached中的唯一标识将会改变,写操作就会失败。
-
存储时间
默认最大过期时间(2592000s = 30 day)
设置最大生存时间
client.set(key, value, new Date(expireTime));memcahced 中数据是怎么存储的
- 关键字
key
主要通过测试,推理memcached的存储机制。 平台 windows7 版本 memcached-1.2.6-win32 启动日志: E:\memcached\memcached-1.2.6-win32-bin>memcached -m 32 -p 12001 -vv
slab class 1: chunk size 88 perslab 11915
slab class 2: chunk size 112 perslab 9362
slab class 3: chunk size 144 perslab 7281
slab class 4: chunk size 184 perslab 5698
slab class 5: chunk size 232 perslab 4519
slab class 6: chunk size 296 perslab 3542
slab class 7: chunk size 376 perslab 2788
slab class 8: chunk size 472 perslab 2221
slab class 9: chunk size 592 perslab 1771
slab class 10: chunk size 744 perslab 1409
slab class 11: chunk size 936 perslab 1120
slab class 12: chunk size 1176 perslab 891
slab class 13: chunk size 1472 perslab 712
slab class 14: chunk size 1840 perslab 569
slab class 15: chunk size 2304 perslab 455
slab class 16: chunk size 2880 perslab 364
slab class 17: chunk size 3600 perslab 291
slab class 18: chunk size 4504 perslab 232
slab class 19: chunk size 5632 perslab 186
slab class 20: chunk size 7040 perslab 148
slab class 21: chunk size 8800 perslab 119
slab class 22: chunk size 11000 perslab 95
slab class 23: chunk size 13752 perslab 76
slab class 24: chunk size 17192 perslab 60
slab class 25: chunk size 21496 perslab 48
slab class 26: chunk size 26872 perslab 39
slab class 27: chunk size 33592 perslab 31
slab class 28: chunk size 41992 perslab 24
slab class 29: chunk size 52496 perslab 19
slab class 30: chunk size 65624 perslab 15
slab class 31: chunk size 82032 perslab 12
slab class 32: chunk size 102544 perslab 10
slab class 33: chunk size 128184 perslab 8
slab class 34: chunk size 160232 perslab 6
slab class 35: chunk size 200296 perslab 5
slab class 36: chunk size 250376 perslab 4
slab class 37: chunk size 312976 perslab 3
slab class 38: chunk size 391224 perslab 2
slab class 39: chunk size 489032 perslab 2
<96 server listening
<112 server listening
<116 send buffer was 8192, now 268435456
<116 server listening (udp)
<120 new client connection
<120 exit
<120 ERROR <120 quit
<120 connection closed.
<120 new client connection日志只是显示了将来的分配策略,并未真正分配内存。 Slab表示块大小的级别,chunk表示slab中的一个块,还有个比较重要的概念就是page,> page表示同一级slab大小的块的集合。 查看数据状态: ```javastats
STAT pid 12212
STAT uptime 10
STAT time 1367559145
STAT version 1.2.6
STAT pointer_size 32
STAT curr_items 0
STAT total_items 0
STAT bytes 0 –已存数据大小
STAT curr_connections 3
STAT total_connections 4
STAT connection_structures 4
STAT cmd_get 0
STAT cmd_set 0
STAT get_hits 0
STAT get_misses 0
STAT evictions 0
STAT bytes_read 11
STAT bytes_written 7
STAT limit_maxbytes 33554432 —最大容量
STAT threads 1
ENDSlab的大小是怎么算出来的呢? slab大小的计算方式: 从0M到1M,按等比数列划分,默认比例因子是1.25.例如上例中:88*1.25=112. 存数据,测试代码: ```javapublic static void main(String[] arg){
byte[] arr=new byte[10246]; //使用7k的块
int i=0;
int n=i+140;
for(;i<n;i++){
boolean status=MemcachedUtil.getInstance().set(String.valueOf(System.currentTimeMillis()+“”+i), arr,6060);
if(!status){
System.out.println(“——————————”);
}
System.out.println(status);
}
}结果: ```javastats slabs
STAT 20:chunk_size 7040 –块大小
STAT 20:chunks_per_page 148 ––每个page中块数量
STAT 20:total_pages 1 ––––只有一个page
STAT 20:total_chunks 148 —第20个slab级别的块数量总和= total_pages* chunks_per_page
STAT 20:used_chunks 148
STAT 20:free_chunks 0
STAT 20:free_chunks_end 8
STAT active_slabs 1
STAT total_malloced 1041920 —所有数据占用内存=140*(7040+key所占内存)
END
stats items
STAT items:20:number 140
STAT items:20:age 241
STAT items:20:evicted 0
STAT items:20:outofmemory 0
END
stats sizes
6240 140
END使用了第20个slab的块(7k的块),使用了140个,还剩8个。 再执行8次: ```javaint i=0;
int n=i+8;(省略了一部分) from: [http://goon.iteye.com/blog/1859291](http://goon.iteye.com/blog/1859291) 可见,当内存被沾满后,如果再存放一种新的slab大小的数据,那么memcached会新开一个且只开一个这种slab大小的page,当这个page被沾满后,就会执行数据替换。这样算下来,memcached中的实际 数据总量可能就会超出启动时设置的32M,因为当一个slab大小的数据把内存沾满后,还可能为每个其他的slab大小的数据额为分配一个page,每个page的大小是1M。例如,如果有39个slab,那么就可能多占用38M的内存。而启动时 -f 因子的大小会决定slab数量的大小,所以也会影响到最后有多少数据会超出容量。
- 关键字
-
内存分配
开启memcached:
memcached -d -m 10 -l 192.168.1.21 -p 11222 -u userA 这行命令会开启memcached服务,memcached在192.168.1.21:112222上面进行监听, 同时设置memcached使用的最大内存为10MB, memcached一开始并不会一下子申请10MB的内存, 而是在需要的时候才会使用malloc申请内存,当申请内存达到10MB时就不会再申请.
为了减少管理内存碎片的麻烦,当你需要通过memcached往缓存里面保存一个数据时, memcached给这个数据提供一个固定大小的内存块(chunk) ,比如数据的长度是100bytes,那么memcached提供一个大小为128b的chunk来存储该数据,chunk块的大小可以为64B,128B,256B…1024KB .使用何种大小的chunk块是由memcache根据数据的长度来决定的.
当你第一次往memcached存储数据时, memcached会去申请1MB的内存 , 把该块内存称为一个slab, 也称为一个page, 如果可以存储这个数据的最佳的chunk大小为128B,那么memcached会把刚申请的slab以128B为单位进行分割成8192块. 当这页slab的所有chunk都被用完时,并且继续有数据需要存储在128B的chunk里面时,如果已经申请的内存小于最大可申请内存10MB 时,memcached继续去申请1M内存,继续以128B为单位进行分割再进行存储;如果已经无法继续申请内存,那么mamcached会先根据LRU 算法把队列里面最久没有被使用到的chunk进行释放后,再将该chunk用于存储.
chunk属于某个slab,slabs由memcached进行分组管理,以同样chunk大小进行分割的slab属于同一组.
对一组slab, memcached使用这样的几个内部变量进行管理:
total_pages
total_chunks
used_chunks
free_chunks
free_chunks_end
> 假设现在一组slab,它的chunk大小是128KB, total_pages =1, 那么
>
> ```
total_chunks = (1MB/128KB) * 1 = 8,
total_chunks=used_chunks + free_chunks,
free_chunks = 被使用过但是已经释放的chunk个数(注:个人理解)
free_chunks_end = 没有被使用过的chunk个数(注:个人理解)
used_chunks = free_chunks_end + 现在存储着数据的chunk个数
>```
>
> 当一个数据在memcached中被删除时, 存储该数据的chunk被释放, 对应slab组的free_chunks++,当有数据想添加到缓存里面时, memcached优先使用free_chunks里面的chunk, 如果free_chunks=0,再使用free_chunks_end里面的chunk, 如果连free_chunks_end也为0, 那么重新申请一页内存.
>
> 通过telnet 192.168.1.21 11222 可以连上memcached, 键入命令 stats slabs 可以看到所有slabs组的统计数据以及统计情况.
memcached安装包scripts/memcached-tool是一个可以查看memcached的slabs统计情况的perl脚本
>
> 为了避免使用memcached时出现异常, 使用memcached的项目需要注意:
> 1. 不能往memcached存储一个大于1MB的数据.
> 2. 往memcached存储的所有数据,如果数据的大小分布于各种chunk大小区间,从64B到1MB都有,可能会造成内存的极大浪费以及memcached的异常.
>
> 举个例子:
>
> memcached 最大可申请内存为2M, 你第一次存储一个10B的数据,那么memcached会申请1MB的内存,以64B进行分割然后存储该数据, 第二次存储一个90B的数据,那么memcached会继续申请1M的内存,以128B进行分割然后存储该数据, 第三次如果你想存储一个150B的数据, 如果可以继续申请内存, memcached会申请1M内存以256B的大小进行分割, 但是由于最大可申请仅仅为2MB,所以会导致该数据无法存储.
>
>
- 内存管理
> Memcached作为一个主要用作访问加速的不落地Cache,其内存主要是使用程序上的堆内存(heap memory),而且内存一旦分配不再释放;同时为了加速对对应内存块访问,采用了Hash桶管理内存的方式;在数据淘汰算法方面使用了LRU。
>
> Memcached的内存分配是按照对于相同的页大小(1MB)分割成相同大小的Chunk实现的,对于不同的slab组,只是体现在具体的Chunk大小不同,每一组slab可以包含若干多的页内存。slab组的定义如下:
>
> static slabclass_t slabclass[POWER_LARGEST+1];
> 所有的内存分配都给予这个全局静态变量,下边说明一下单个slabclass结构体中各个变量的定义:
>
> ```
typedef struct {
unsigned int size;
unsigned int perslab;
void **slots;
unsigned int sl_total;
unsigned int sl_curr;
void *end_page_ptr;
unsigned int end_page_free;
unsigned int slabs;
void **slab_list;
unsigned int list_size;
unsigned int killing;
} slabclass_t;
> ```
>
> size:指当前slabclass中页内存中chunk块的大小,也就是单个item的大小;
>
> perslab:指一个页内存中可以划分为多少个chunk块,大小为1M/2^currentId,>
>
> currentId指的是当前slab在slabclass的数组索引号。
>
> slots:指向free chunk块的指针数组,slots的指针指向一个void *的数组,该数组中的每一个元素的内容均指向一个空闲的chunk块,而且相同slabclass上的所有slab中的free chunk块均挂接到这个链表上;
>
> sl_total:当前slots指针数组的大小,如果大小不够则将以2*sl_total的大小重新分配;
> sl_curr:指向当前空闲数组链表的第一个可用位置;
>
> end_page_ptr:指向当前slabclass中最后分配的内存页的第一个可用chunk的地址,或者指向NULL表示目前的内存页已经用完;
> end_page_free:当前slabclass中最后分配的内存也中下一个可用chunk的索引位置;
>
> slabs:当前slabclass中分配的页内存个数;
>
> slab_list:当前slabclass所分配的页内存(slab)的指针数组,每一个数组元素的内容均是一个指向页内存地址的指针;
> list_size:当前分配的内存页的个数;
> killing:在slab assign的过程中会用到。
>
> 在分配一个chunk块的时候,原则上是先从slots上查找空闲的chunk块指针,如果没有找到那么需要从slabclass中的已分配内存页上需找第一个可用的chunk块,如果仍然没有找到则给当前slabclass分配另外的一个内存页,并分配该页上的第一个chunk块。当释放一个chunk块的时候,将slot上的最后一个空闲位置的指针的值赋值为该chunk块的指针,这样以来chunk块只会从slabclass的页内存转移到空闲chunk列表上。
### memcache 与 memcached
> Memcache是什么?
>
> Memcache是一个自由和开放源代码、高性能、分配的内存对象缓存系统。用于加速动态web应用程序,减轻数据库负载。它可以应对任意多个连接,使用非阻塞的网络IO。由于它的工作机制是在内存中开辟一块空间,然后建立一个HashTable,Memcached自管理这些HashTable。
>
> Memcached是简单而强大的。它简单的设计促进迅速部署,易于发展所面临的问题,解决了很多大型数据缓存。它的API可供最流行的语言。
>
> Memcache官方网站:http://memcached.org/
>
> Memcached又是什么?
>
> Memcache是该系统的项目名称,Memcached是该系统的主程序文件(字母d可以理解为domain),以守护程序方式运行于一个或多个服务器中,随时接受客户端的连接操作,使用共享内存存取数据。
>
> PHP中的Memcache是什么?
>
> php中的所讲的memcache是用于连接Memecached的客户端组件。
## Mysql
### 联合索引
### 优化性能
### 执行优先顺序
### sphinx 的优缺点
### mysql 性能极限
## Yii2
### 框架源码
### **框架运行流程(从入口文件开始)**
- one
> 我是从入口处分析的。
>
> $mysiteRoot/frontend
>
> 首先:$mysiteRoot/frontend/index.php
>
> ```php
$application = new yii\web\Application($config);//先从这入手
$application->run();//先不急,后面会提到
> ```
>
> 从上面注释的位置入口
>
> $config为配置文件,这里我们来看看是如何加载配置文件内容的。
>
> 顺着application我们能找到:yii\web\Application.php
>
> ```php
class Application extends \yii\base\Application
> ```
>
> yii\web\Application.php中没有构造函数,所以我们顺理成章的找找
>
> 它的父类也就是\yii\base\Application,看看父类里面是否有构造函数
>
> \yii\base\Application没有让我们失望,
>
> 构造方法如下:
>
> ``` php
> abstract class Application extends Module{
> .....
> public function __construct($config = [])
> {
>
> Yii::$app = $this;
>
> $this->setInstance($this);//将\yii\base\Application中的所有的属性和方法交给Yii::$app->loadedModules数组中
>
> $this->state = self::STATE_BEGIN;
>
> $this->preInit($config);//加载配置文件的框架信息 如:设置别名,设置框架路径等等 最为重要的是给加载默认组件
>
> $this->registerErrorHandler($config);//加载配置文件中的异常组件
>
> Component::__construct($config);//将配置文件中的所有信息赋值给Object,也就是Yii::$app->配置文件参数可以直接调用配置文件的内容
> //如:Yii::$app->vendorPath//输出框架路径 Yii::$app->components['redis']//输出redis配置信息
> }
> ......
> ```
>
> 下面我们来分析下面的代码
>
> 首先是:Yii::$app = $this;
>
> 这一句指的是,将\yii\base\Application里所有的公共方法都交给了,Yii::$app,其实Yii大部分信息都在Yii::$app变量中
>
> 当然也包括它的父类如:\yii\base\Module \yii\di\ServiceLocator \yii\base\Component \yii\base\Object
>
> ```php
> $this->setInstance($this);//module里会用到,为getInstance提供
> ```
>
> 这一句是指向\yii\base\Module
>
> ```php
> public static function setInstance($instance)//module模块里会用到,为getInstance提供
{
if ($instance === null) {
unset(Yii::$app->loadedModules[get_called_class()]);
} else {
Yii::$app->loadedModules[get_class($instance)] = $instance;
}
}
> ```
>
> 这句意思是:将当前类名和存储类的对象变量加入Yii::$app->loadedModules['yii\web\Application']数组中
>
> 这样直接通过Yii::$app->loadedModules['yii\web\Application']就可以直接调用这个类
>
> 重要的用处在于后面的使用如:
>
> 在Module里,也就是module使用的时候,可以通过self::getInstance()获取App对象,类似于Yii::$app。这个研究的比较浅,以后再深入,有疑问的童鞋可以深入
>
> ```php
> Yii::$app = $this;
$this->setInstance($this);
> ```
>
> 这两句做的操作是一样的,其实是有所不同的。
>
> ```php
> Yii::$app = $this;
> ```
>
> 指的是通过Yii::$app可以调用yii\web\Application及其父类所有的方法
>
> ```php
> Yii::$app->loadedModules['yii\web\Application']//也能同样做到
> ```
>
> loadedModules是一个数组,存放成员类的。它除了能调用当前,还能调用其它许许多多的类....
>
> ```php
> $this->preInit($config);
> ```
>
> 这一句是将配置文件中的一些变量设置别名,主要是针对路径、URL之类的
>
> ```php
> $this->registerErrorHandler($config);
> ```
>
> 加载异常处理,这块比较深就先不研究了,觉得比较浅的童鞋可以接着补充哈
>
> ```php
> Component::__construct($config);
> ```
>
> 这一句指向Object
>
> ```php
> public function __construct($config = [])
{
if (!empty($config)) {
Yii::configure($this, $config);//将配置文件里面的所有配置信息赋值给Object,由于Object是大部分类的基类,实际上也就是交给了yii\web\Application 您可以Yii::$app->配置参数来访问配置文件中的内容
}
$this->init();//下面会细分析
}
foreach ($this->coreComponents() as $id => $component) {//加载默认组件components
if (!isset($config['components'][$id])) {
$config['components'][$id] = $component;
} elseif (is_array($config['components'][$id]) && !isset($config['components'][$id]['class'])) {
$config['components'][$id]['class'] = $component['class'];
}
}
> ```
>
> 这个就是把当前的配置文件config变量中内容交给Object 再就是讲components默认需要加载的组件类,赋到config配置文件变量中。
>
> Object是基础类,所以绝大部分类都能直接调用配置文件中配置内容
>
> 如:
>
> ```php
> var_dump(Yii::$app->name);
> ```
>
> 实际上config文件的数组中有name属性
>
> ```php
> return [
'id' => 'app-frontend',
'name' => '环球在线',
......
> ```
>
> 再回到Object
>
> ```php
> public function __construct($config = [])
{
if (!empty($config)) {
Yii::configure($this, $config);
}// 这以上已经执行完了
$this->init();//接下来分析这一句
}
$this->init();
> ```
>
> 这句实际上执行的是yii\base\Module.php
>
> ```php
/*
取出控制器的命名空间,您也可以理解为路径(* 注:第一次加载它的时候。)
表面看起来没有太多的意义,实则不然,yii2的大部分组件都是以Object为基类的,
所以init函数很重要,控制器、模型、模块module,自定义组件等都可以去实现init方法。
比如说默认的控制器SiteController吧。在里面写一个init方法,当你访问site控制器下任意的$route路径,
都会先执行init方法。作用大不?其它组件同样如此。
*/
public function init()
{
if ($this->controllerNamespace === null) {
$class = get_class($this);
if (($pos = strrpos($class, '\\')) !== false) {
$this->controllerNamespace = substr($class, 0, $pos) . '\\controllers';
}
}
}
> ```
>
> 至此第一部分执行完了,再看第二部分吧
>
> ```php
> $application = new yii\web\Application($config);//分析完成
$application->run();//加载主要组件,运行默认控制器
> ```
>
> 接下拆分 $application->run吧
>
> 用ide指向直接到了\yii\base\Application.php
>
> ```php
public function run()
{
try {
>
$this->state = self::STATE_BEFORE_REQUEST;
$this->trigger(self::EVENT_BEFORE_REQUEST);//加载事件函数函数的。这一句以后再分析吧
>
$this->state = self::STATE_HANDLING_REQUEST;
$response = $this->handleRequest($this->getRequest());//这里才是加载控制器的地方,我也迷惑了半天
>
$this->state = self::STATE_AFTER_REQUEST;
$this->trigger(self::EVENT_AFTER_REQUEST);//加载事件函数
>
$this->state = self::STATE_SENDING_RESPONSE;
$response->send();//将页面内容输入缓冲,然后输出
>
$this->state = self::STATE_END;
>
return $response->exitStatus;
>
} catch (ExitException $e) {
>
$this->end($e->statusCode, isset($response) ? $response : null);
return $e->statusCode;
>
}
}
$response = $this->handleRequest($this->getRequest());
> ```
>
>
> 摘出来的这句:
>
> ```php
> $this->getRequest()//获取Request对象
> ```
>
> 这个没啥可说的,获取Request对象
>
> ```php
> $this->handleRequest($this->getRequest());
> ```
>
> 通过指向\yii\web\Application.php
>
> ```php
public function handleRequest($request)
{
if (empty($this->catchAll)) {
list ($route, $params) = $request->resolve();//取出路由及参数
} else {
$route = $this->catchAll[0];
$params = $this->catchAll;
unset($params[0]);
}
try {
Yii::trace("Route requested: '$route'", __METHOD__);
$this->requestedRoute = $route;
$result = $this->runAction($route, $params);//运行控制器中的Acition,下面有详细介绍
if ($result instanceof Response) {
return $result;
} else {
$response = $this->getResponse();
>
/*这个是加载yii\base\Response类,在外部可以Yii::$app->get('response')、Yii::$app->getResponse()、Yii::$app->response 等等方式来加载response类,主要用来加载http状态,及头信息,如301,302,404,ajax头等等的获取*/
>
if ($result !== null) {
$response->data = $result;
}
>
return $response;
}
} catch (InvalidRouteException $e) {
throw new NotFoundHttpException(Yii::t('yii', 'Page not found.'), $e->getCode(), $e);
}
}
>
$result = $this->runAction($route, $params);//运行控制器
> ```
>
> 我们再看看这句指向:\yii\base\Module.php
>
> ```php
public function runAction($route, $params = [])
{
$parts = $this->createController($route);//根据路由创建控制器
if (is_array($parts)) {
/* @var $controller Controller */
list($controller, $actionID) = $parts;//获得$actionId和$controller
$oldController = Yii::$app->controller;
Yii::$app->controller = $controller;
$result = $controller->runAction($actionID, $params);//运行使用控制器加载 action方法
Yii::$app->controller = $oldController;//将对象交给Yii::$app->controller 这里面起的作用应该是运行控制器,最后释放控制器的对象变量
>
return $result;
} else {
$id = $this->getUniqueId();
throw new InvalidRouteException('Unable to resolve the request "' . ($id === '' ? $route : $id . '/' . $route) . '".');
}
}
> ```
>
>
> Module里有一段:
>
> ```php
$controller = Yii::createObject($this->controllerMap[$id], [$id, $this]);
> ```
>
> 其实在
>
> ```php
> $this->createController($route)
> ```
>
> 这个时候创建了控制器对象
>
> 下面看看如何加载action的。
>
> ```php
> $result = $controller->runAction($actionID, $params);//运行使用控制器加载 action方法
> ```
>
> 上面这句指向:
>
> ```php
public function runAction($id, $params = [])
{
$action = $this->createAction($id);//创建action
if ($action === null) {
throw new InvalidRouteException('Unable to resolve the request: ' . $this->getUniqueId() . '/' . $id);
}
>
Yii::trace("Route to run: " . $action->getUniqueId(), __METHOD__);
>
if (Yii::$app->requestedAction === null) {
Yii::$app->requestedAction = $action;
}
>
$oldAction = $this->action;
$this->action = $action;
>
$modules = [];
$runAction = true;
>
// 加载默认模块如:Application log等。再调用模块内的beforeAction方法
foreach ($this->getModules() as $module) {
if ($module->beforeAction($action)) {
array_unshift($modules, $module);
} else {
$runAction = false;
break;
}
}
>
$result = null;
>
if ($runAction && $this->beforeAction($action)) {//执行beforeAction
// run the action
$result = $action->runWithParams($params);//执行控制器里的action
>
$result = $this->afterAction($action, $result);//执行beforeAction
>
>
// call afterAction on modules
foreach ($modules as $module) {
/* @var $module Module */
$result = $module->afterAction($action, $result);
}
}
>
$this->action = $oldAction;
>
return $result;
}
$result = $action->runWithParams($params);//执行控制器里的action
> ```
>
> 这里才是真正执行action的地方
>
> 首先弄清楚$action是什么类?这里可以var_dump一下就清楚了,刚开始我也被编辑器迷糊了找半天
>
> $action类是yii\base\InlineAction
>
> ```php
public function runWithParams($params)
{
$args = $this->controller->bindActionParams($this, $params);//对action的参数进行分析,并且赋值给控制器
Yii::trace('Running action: ' . get_class($this->controller) . '::' . $this->actionMethod . '()', __METHOD__);
if (Yii::$app->requestedParams === null) {
Yii::$app->requestedParams = $args;
}
>
return call_user_func_array([$this->controller, $this->actionMethod], $args);//用控制器类去执行action方法,并且带上参数。
}
> ```
>
>
>
- two (controllers)
>
> 先说一下Yii中的控制器是做什么用的,以及在什么地方使用.
>
> 在Yii中,当请求一个Url的时候,首先在application中获取request信息,然后由request通过urlManager解析出route,再在Module中根据route来创建controller并处理request。
>
> 如: http://www.yiifans.com/index.php?r=site/login 。会使用SiteController里面的actionLogin动作来处理这个请求。
>
> Yii中总共有三种控制器类
>
> ```
baseController.php 这个是下面两个的基类
consoleController.php 这个是控制台控制器
webController.php 这个是web控制器
> ```
>
> 先看看基类baseController.php,在基类中大致可分为三个部分
>
> ```
和action相关的功能
和render相关的功能
其它功能
> ```
>
> 1、和action相关的函数
>
> 我们按照这些函数的调用顺序来一一说明
>
> 执行路由:public function run($route, $params = [])
>
> ```php
/\*
\* route值即可以为当前controller中的action id,
\*
\* 也可为module id/controller id/action id/这种格式
\* 如果以“/”开头,将于application来处理,否则,用控制器所属模块来处理
\*/
public function run($route, $params = [])
{
//先判断route中有没有“/”
$pos = strpos($route, '/');
if ($pos === false) {
//如果没有“/”,则为action id,直接调用runAction来执行这个action。如:index
return $this->runAction($route, $params);
}
>
elseif ($pos > 0) {
//如果“/”在中间,由当前的模块来处理这个route。如:test/index
return $this->module->runAction($route, $params);
}
>
else {
//如果以“/”开头,则用当前的应用程序来处理这个route。如:/test/index;
return Yii::$app->runAction(ltrim($route, '/'), $params);
}
}
> ```
> 执行动作:public function runAction($id, $params = [])
>
> ```php
/\*
\* $id 为action的id,如定义的actionIndex,那么id就为Index。
\*
\*/
public function runAction($id, $params = [])
{
//创建action
$action = $this->createAction($id);
>
if ($action === null) {
throw new InvalidRouteException('Unable to resolve the request: ' . $this->getUniqueId() . '/' . $id);
}
>
Yii::trace("Route to run: " . $action->getUniqueId(), __METHOD__);
>
if (Yii::$app->requestedAction === null) {
Yii::$app->requestedAction = $action;
}
>
$oldAction = $this->action;
>
$this->action = $action; //用来保存当前控制器的所有父模块,顺序为由子模块到父模块
>
$modules = [];
>
$runAction = true;
>
/*
* 获取当前控制器的所以的模块,并执行每个模块的beforeAction来检查当前的action是否可以执行, 注意:getModules返回的数组顺序为:从父模块到子模块, 所以在执行beforeAction的时候,先检查最外层的父模块,然后检查子模块。
* * 然而在执行afterAction的时候,顺序就反过来了,先执行子模块,最后执行父模块。
* */
>
foreach ($this->getModules() as $module) {
if ($module->beforeAction($action)) {
>
array_unshift($modules, $module);
}
>
else {
$runAction = false;
break;
}
}
>
$result = null; //如果所以的父模块都满足执行的条件
>
if ($runAction) {
/* * 再判断当前控制器中是beforeAction,最后由生成的action对象来执行runWithParams方法
* * 执行完后,再执行afterAction方法
*/
if ($this->beforeAction($action)) {
$result = $action->runWithParams($params);
$result = $this->afterAction($action, $result);
}
}
>
//执行所有父模块的afterAction
foreach ($modules as $module) {
/** @var Module $module */
$result = $module->afterAction($action, $result);
}
>
$this->action = $oldAction;
return $result;
}
> ```
>
> 创建动作 public function createAction($id)
>
> ```php
//由action id来创建action对象
public function createAction($id)
{
//使用默认的action id ,默认值为:index
if ($id === '') {
$id = $this->defaultAction;
}
>
$actionMap = $this->actions();
if (isset($actionMap[$id])) {
//如果在actions方法中指定了独立的动作,则直接使用此动作。
return Yii::createObject($actionMap[$id], [$id, $this]);
} elseif (preg_match('/^[a-z0-9\\-_]+$/', $id) && strpos($id, '--') === false && trim($id, '-') === $id) {
/*
* action id由:a到z、0到9、\、-、_ 这五种字符组成,
* 并且不能包含“--”
* 并且不能以“-”为开头或结尾
*
* 先以“-”把id分隔为数组,再以“ ”连接到字符串,把每个单词首字母大写,最后把“ ”去掉,并和"action"连接
* 如;
* 1、new-post-v-4
* 2、['new','post','v','4']
* 3、new post v 4
* 4、New Post V 4
* 5、NewPostV4
* 6、actionNewPostV4
*/
$methodName = 'action' . str_replace(' ', '', ucwords(implode(' ', explode('-', $id))));
if (method_exists($this, $methodName)) {
/*
* 如果当前控制器中存在这个actionXXX方法,
* 再通过反射生成方法,再次检查一遍,最后生成InlineAction
*/
$method = new \ReflectionMethod($this, $methodName);
if ($method->getName() === $methodName) {
return new InlineAction($id, $this, $methodName);
}
}
}
>
return null;
}
> ```
>
> 所以,如果一个动作在定义的时候是用骆驼格式名称的,如actionNewArticle,那么写url的时候r=site/new-article。详情见Yii2.0中文开发向导——控制器(Controller)中的路由部分。
>
> 定义独立动作的数组:public function actions()
>
> ```php
/\*
\* 独立action定义
\* 这个用来指定独立的action,返回格式为name-value的数组,name为action的id,value为action类的实现,如:
\* return [
\* 'action1' => 'app\components\Action1',
\* 'action2' => [
\* 'class' => 'app\components\Action2',
\* 'property1' => 'value1',
\* 'property2' => 'value2',
\* ],
\* ];
\* 这个主要是用于在子类中重写
\*/
public function actions()
{
return [];
}
> ```
> 由createAction可知,当controller在创建action的时候,会根据动作ID先在这个数组里面查找,如果找到则返回这个动作。所以这里定义的动作的优先级要大于在控制器里面定义的actionXXX函数。
>
> 绑定动作的参数:public function bindActionParams($action, $params)
>
> ```php
/*
* 绑定action的参数。
* 比如定义了动作 actionCrate($id,$name=null)
* 那个这个函数的作用就是从params(一般为$_GET)中提取$id,$name,
*
* 具体的实现在web\Controller.php和console\Controller.php中
*/
public function bindActionParams($action, $params)
{
return [];
}
> ```
>
> beforeAction、afterAction,事件触发
>
> ```php
//在具体的动作执行之前会先执行beforeAction,如果返回false,则动作将不会被执行,
//后面的afterAction也不会执行(但父模块跌afterAction会执行)
public function beforeAction($action)
{
$event = new ActionEvent($action);
$this->trigger(self::EVENT_BEFORE_ACTION, $event);
return $event->isValid;
}
>
//当前动作执行之后,执行afterAction
public function afterAction($action, $result)
{
$event = new ActionEvent($action);
$event->result = $result;
$this->trigger(self::EVENT_AFTER_ACTION, $event);
return $event->result;
}
> ```
>
> 在这个都会触发事件,beforeAction触发EVENT_BEFORE_ACTION事件,afterAction触发EVENT_AFTER_ACTION
>
> 2、和render相关的功能
>
> 获取、设置view组件:public function getView()、public function setView($view)
>
> ```php
//获取view组件,
public function getView()
{
if ($this->_view === null) {
$this->_view = Yii::$app->getView();
}
>
return $this->_view;
}
//设置view组件
public function setView($view)
{
$this->_view = $view;
}
> ```
>
> 渲染视图文件和布局文件(如果有布局的话):public function render($view, $params = [])
>
> ```php
//渲染视图文件和布局文件(如果有布局的话)
public function render($view, $params = [])
{
//由view对象渲染视图文件
$output = $this->getView()->render($view, $params, $this);
//查找布局文件
$layoutFile = $this->findLayoutFile($this->getView());
if ($layoutFile !== false) {
//由view对象渲染布局文件,
//并把上面的视图结果作为content变量传递到布局中,所以布局中才会有$content变量来表示
return $this->getView()->renderFile($layoutFile, ['content' => $output], $this);
} else {
return $output;
}
}
> ```
> 渲染视图文件,不会应用布局:public function renderPartial($view, $params = [])
>
> ```php
//这个只渲染视图文件,不会应用布局
public function renderPartial($view, $params = [])
{
return $this->getView()->render($view, $params, $this);
}
> ```
>
> 渲染文件:public function renderFile($file, $params = [])
>
> ```php
//这个就是用来渲染一个文件,$file为文件实路径或别名路径
public function renderFile($file, $params = [])
{
return $this->getView()->renderFile($file, $params, $this);
}
> ```
>
> 获取这个控制器对应的view的文件路径:public function getViewPath()
>
> ```php
//获取这个控制器对应的view的文件路径,如@app/views/site/xxxx.php
public function getViewPath()
{
return $this->module->getViewPath() . DIRECTORY_SEPARATOR . $this->id;
}
> ```
> 查找布局文件:protected function findLayoutFile($view)
>
> ```php
//查找布局文件
protected function findLayoutFile($view)
{
$module = $this->module;
//如果当前控制器设置了布局文件,则直接使用所设置的布局文件
if (is_string($this->layout)) {
$layout = $this->layout;
} elseif ($this->layout === null) {
//如果没有设置布局文件,则查找所有的父模块的布局文件。
while ($module !== null && $module->layout === null) {
$module = $module->module;
}
if ($module !== null && is_string($module->layout)) {
$layout = $module->layout;
}
}
>
//如果没有设置布局文件,返回false
if (!isset($layout)) {
return false;
}
>
/*
* 布局文件有三种路径写法
* 1、以“@”开头,这种会在别名路径中查找布局文件
* 2、以“/”开头,这个会从应用程序的布局文件目录下面查找布局文件
* 3、其它情况, 这个会从当前模块的布局文件目录下查查找布局文件
*/
if (strncmp($layout, '@', 1) === 0) {
$file = Yii::getAlias($layout);
} elseif (strncmp($layout, '/', 1) === 0) {
$file = Yii::$app->getLayoutPath() . DIRECTORY_SEPARATOR . substr($layout, 1);
} else {
$file = $module->getLayoutPath() . DIRECTORY_SEPARATOR . $layout;
}
>
//如果布局文件有文件扩展名,返回
if (pathinfo($file, PATHINFO_EXTENSION) !== '') {
return $file;
}
//加上默认的文件扩展名。
$path = $file . '.' . $view->defaultExtension;
//如果文件不存在,并且,默认的文件扩展名也不是php,则给加上php作为扩展名。
if ($view->defaultExtension !== 'php' && !is_file($path)) {
$path = $file . '.php';
}
>
return $path;
}
> ```
>
> 3、其它功能
>
> 获取当前控制器所有的父模块:public function getModules()
>
> ```php
//获取当前控制器所有的父模块
public function getModules()
{
$modules = [$this->module];
$module = $this->module;
while ($module->module !== null) {
//由这里可知,返回的数组顺序为从父模块到子模块
array_unshift($modules, $module->module);
$module = $module->module;
}
return $modules;
}
> ```
>
> 获取控制器id:public function getUniqueId()
>
> ```php
//返回控制器id
public function getUniqueId()
{
//如果当前所属模块为application,则就为该id,否则要前面要加上模块id
return $this->module instanceof Application ? $this->id : $this->module->getUniqueId() . '/' . $this->id;
}
> ```
>
> 获取路由信息:public function getRoute()
>
> ```php
//获取路由信息
public function getRoute()
{
return $this->action !== null ? $this->action->getUniqueId() : $this->getUniqueId();
}
> ```
>
> 另外还有几个变量和2个事件
>
> ```php
//在执行beforeAction方法时触发的事件,
//如果对事件的isValid属性设置为false,将取消action的执行
const EVENT_BEFORE_ACTION = 'beforeAction';
//在执行afterAction方法是触发的事件
const EVENT_AFTER_ACTION = 'afterAction';
//控制器id
public $id;
//所属模块
public $module;
//控制器中默认动作
public $defaultAction = 'index';
//布局文件,如果设置为false,则不使用布局文件
public $layout;
//当前下面执行的action,可在事件中根据这个action来执行不同的操作
public $action;
//视图对象
private $_view;
> ```
>
>
- yii 源码分析~
[Yii2.0源码分析——目录](http://www.yiifans.com/forum.php?mod=viewthread&tid=60&fromuid=2)
### CSRF
- CSRF(Cross-site request forgery跨站请求伪造,也被称为“One Click Attack”或者Session Riding,通常缩写为CSRF或者XSRF,是一种对网站的恶意利用。尽管听起来像跨站脚本(XSS),但它与XSS非常不同,并且攻击方式几乎相左。XSS利用站点内的信任用户,而CSRF则通过伪装来自受信任用户的请求来利用受信任的网站。与XSS攻击相比,CSRF攻击往往不大流行(因此对其进行防范的资源也相当稀少)和难以防范,所以被认为比XSS更具危险性。
## 算法
## 正则
- 经典题目:取 href
1. `/<a(.*?)href="(.*?)"(.*?)>(.*?)<\/a>/i`
2. sample
```php
$str = '<a id="top8" href="http://list.mp3.baidu.com /song/A.htm?top8" class="p14" target="_top">歌曲列表</a><br><a target="_blank" id="bp" href="http://ibtimes.com" class="p14">中文金曲榜</a><br><a id="top19" href="http://africa.ibtimes.com/sections/companies/" class="p14" target="_top">轻音乐</a></td>';
$pat = '/<a(.*?)href="(.*?)"(.*?)>(.*?)<\/a>/i';
preg_match_all($pat, $str, $m);
print_r($m);
```
answer
```php
Array
(
[0] => Array
(
[0] => <a id="top8" href="http://list.mp3.baidu.com /song/A.htm?top8" class="p14" target="_top">歌曲列表</a>
[1] => <a target="_blank" id="bp" href="http://ibtimes.com" class="p14">中文金曲榜</a>
[2] => <a id="top19" href="http://africa.ibtimes.com/sections/companies/" class="p14" target="_top">轻音乐</a>
)
[1] => Array
(
[0] => id="top8"
[1] => target="_blank" id="bp"
[2] => id="top19"
)
[2] => Array
(
[0] => http://list.mp3.baidu.com /song/A.htm?top8
[1] => http://ibtimes.com
[2] => http://africa.ibtimes.com/sections/companies/
)
[3] => Array
(
[0] => class="p14" target="_top"
[1] => class="p14"
[2] => class="p14" target="_top"
)
[4] => Array
(
[0] => 歌曲列表
[1] => 中文金曲榜
[2] => 轻音乐
)
)
```
- 各个特殊字符意义:
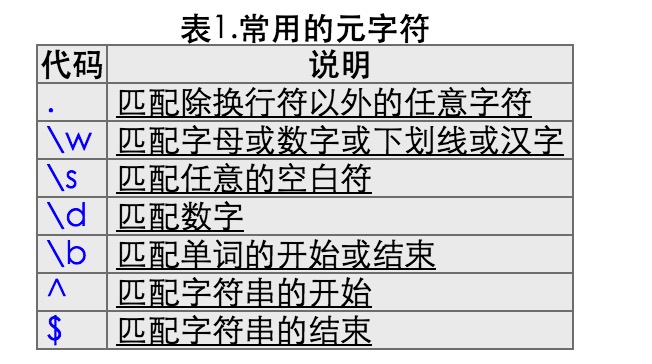
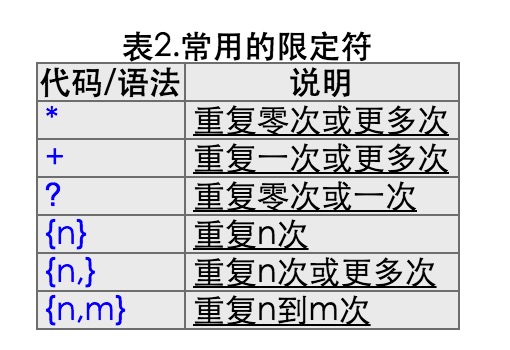
```
1. '.', '*', '?', '+'
2. '\s', '\w', '\d'
```
1. ~~
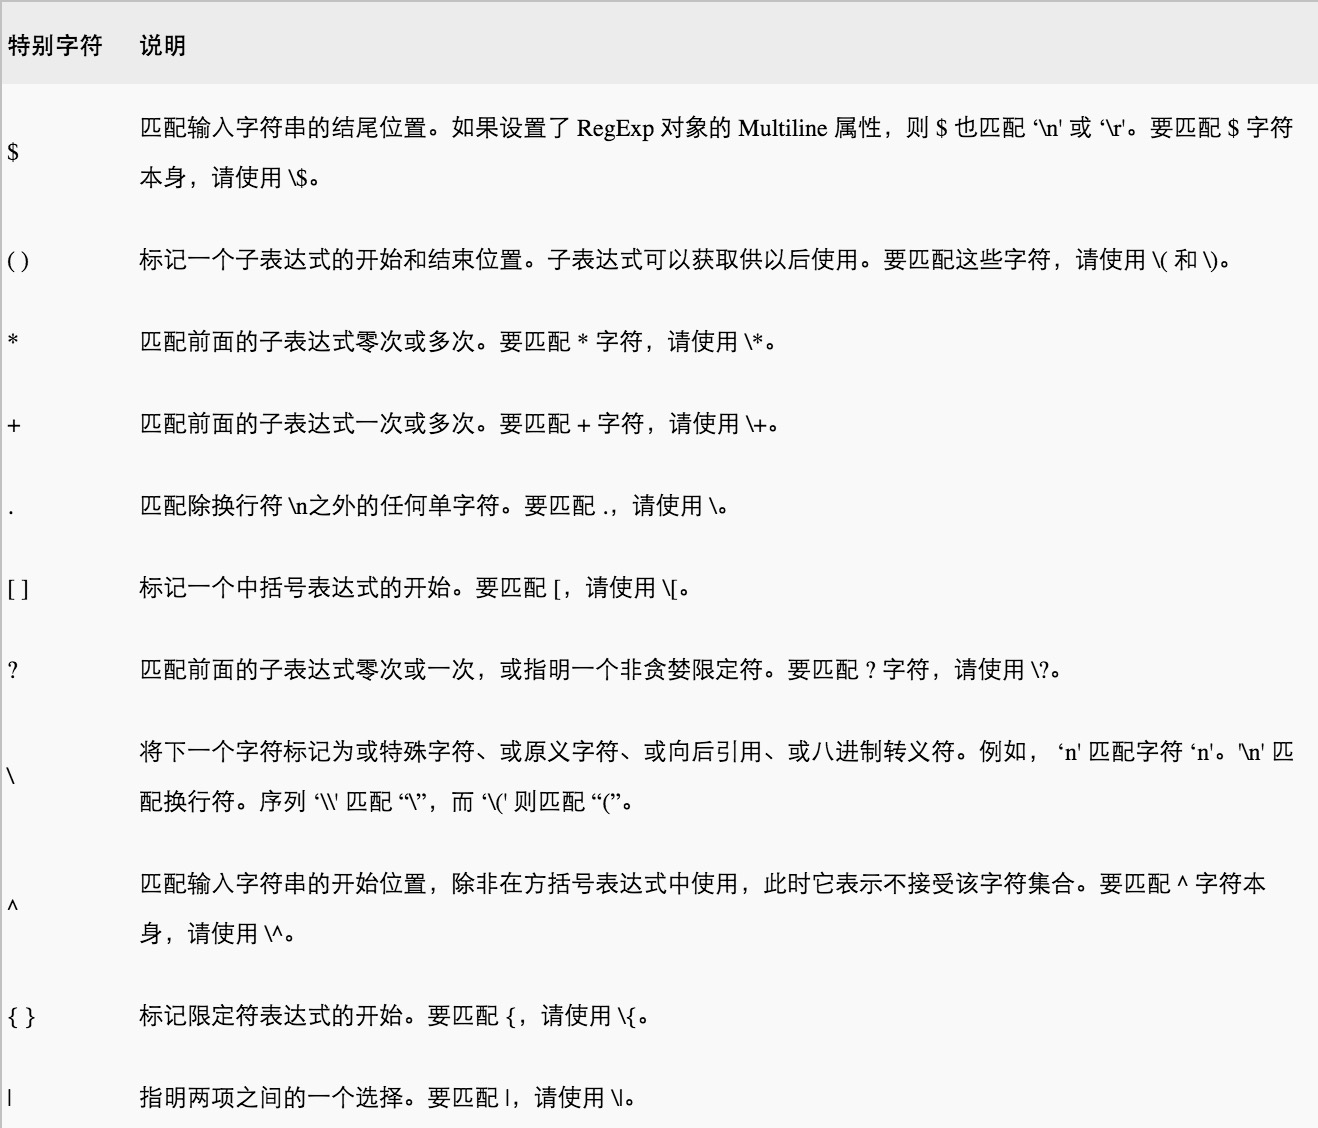
var | desc |
---- | ---- |
`$` | 匹配输入字符串的结尾位置。如果设置了 RegExp 对象的 Multiline 属性,则 `$` 也匹配 `\n` 或 `\r`。
`*` | 匹配前面的子表达式零次或多次。
`+` | 匹配前面的子表达式一次或多次。
`.` | 匹配除换行符 `\n` 之外的任何单字符。
`?` | 匹配前面的子表达式零次或一次,或致命一个非贪婪限定字符。
`\` | 行下一个字符标记为特殊字符、或原义字符、或向后引用、或八进制转义符。
`^` | 匹配输入字符串的开始位置;除非在方括号表达式中使用,此时它表示不接受该字符集合。
`|` | 指明两项之间的一个选择。
`()` | 标记一个子表达式的开始和结束位置。子表达式可以获取供以后使用。
`[]` | 标记一个中括号表达式的开始。
`{}` | 标记限定表达式的开始。
2. other
- 元字符
- 限定字符
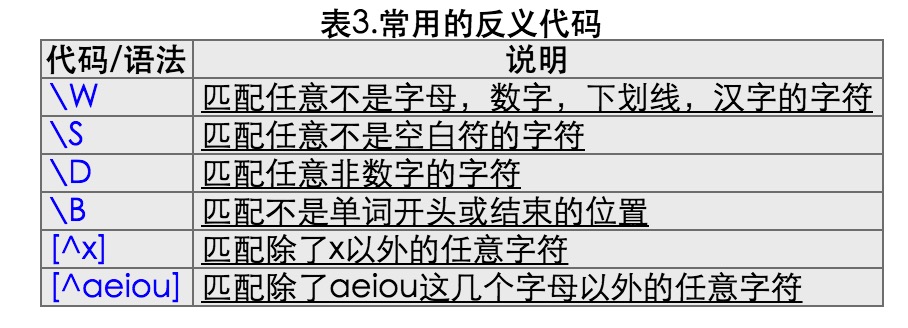
- 反义代码
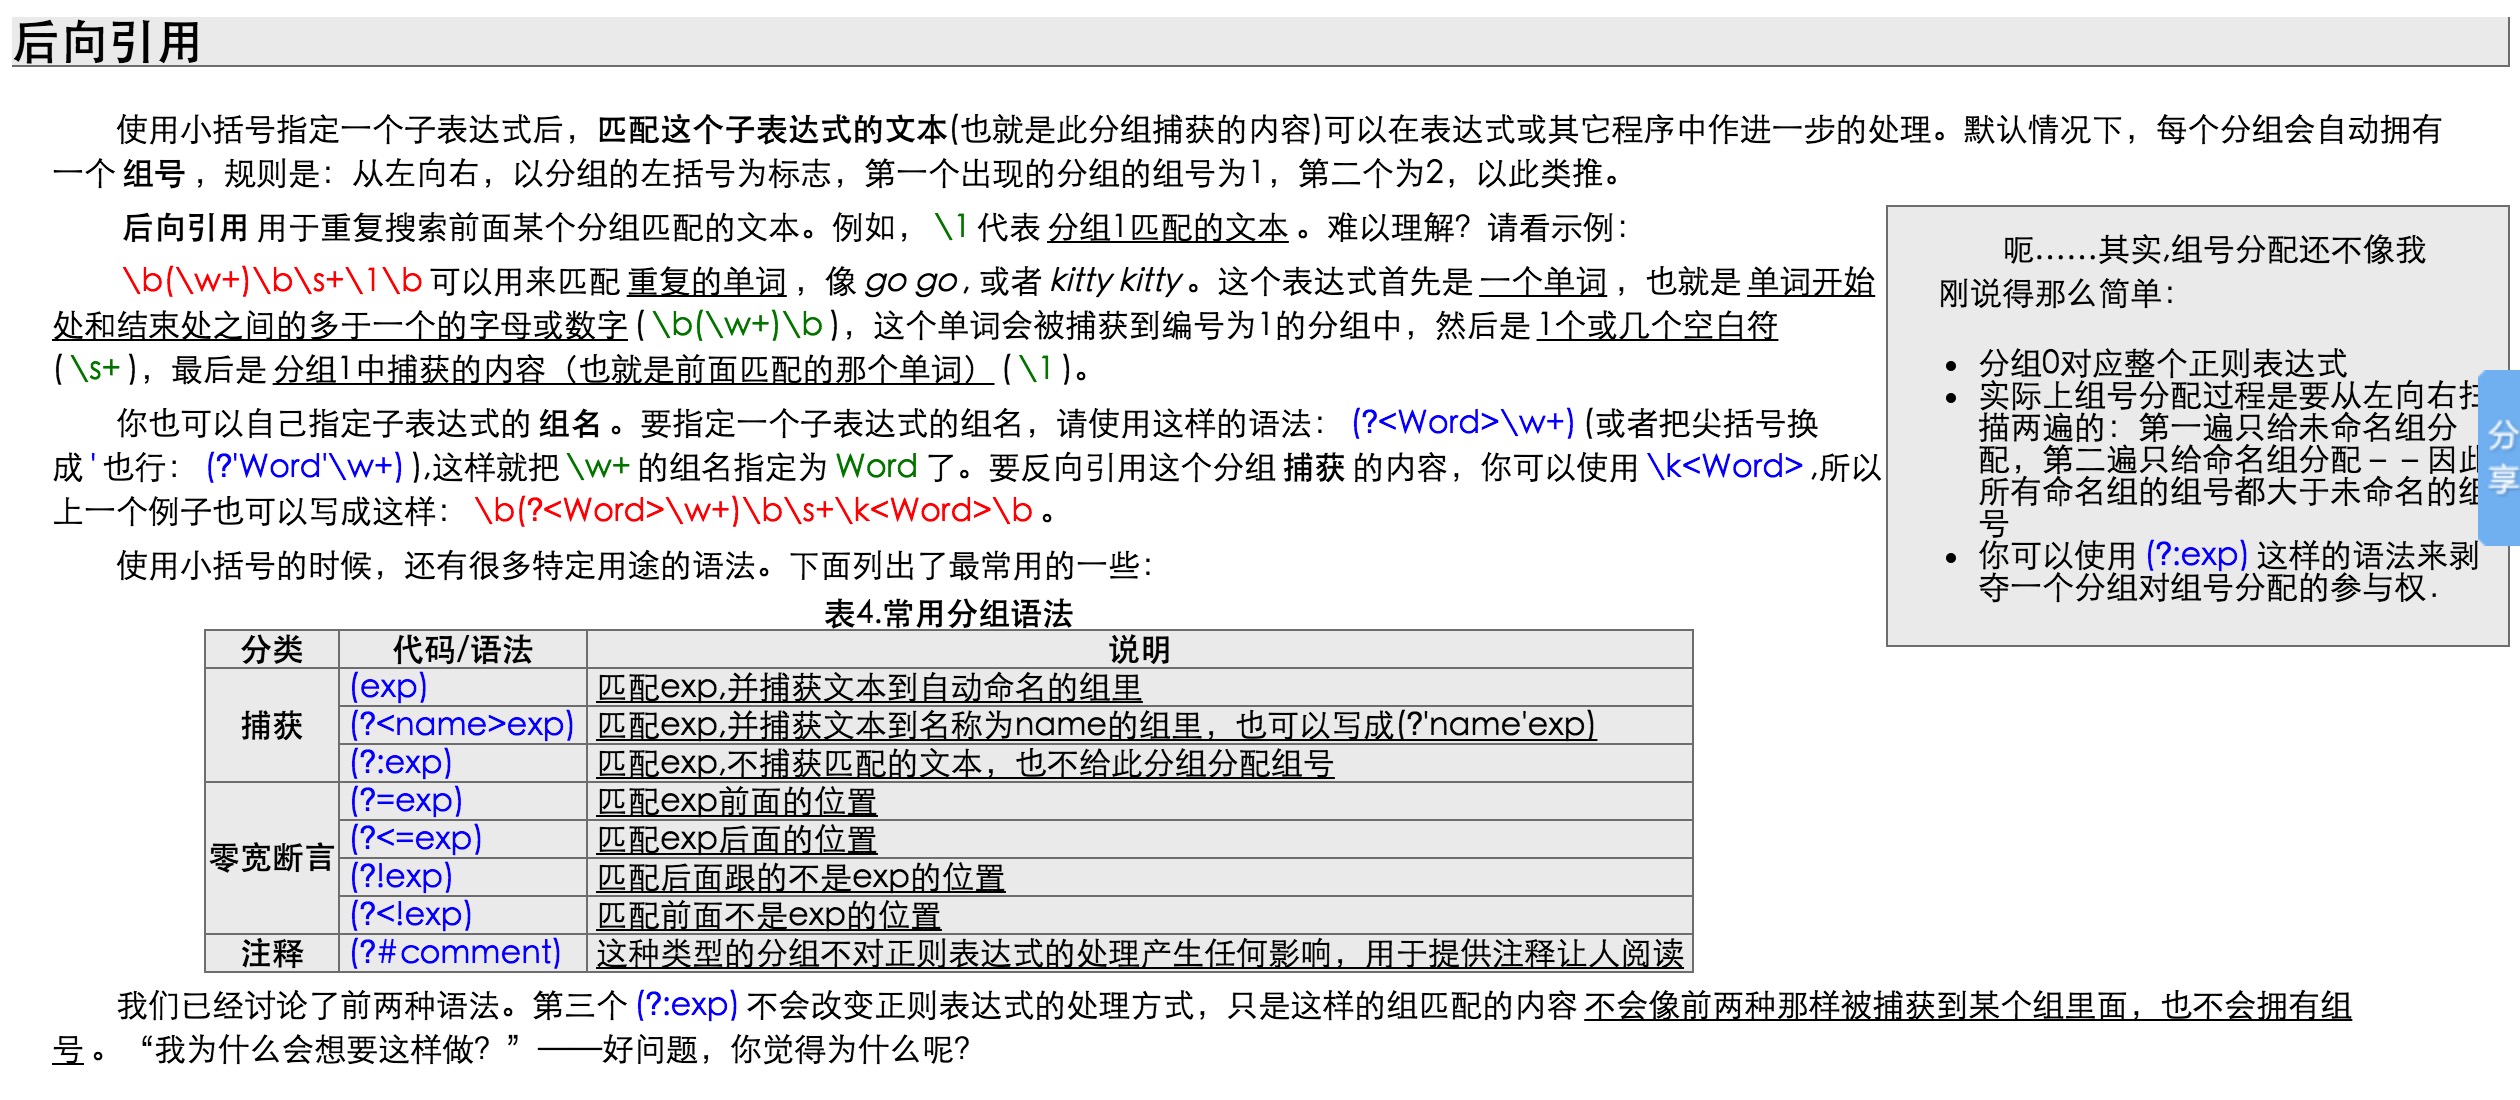
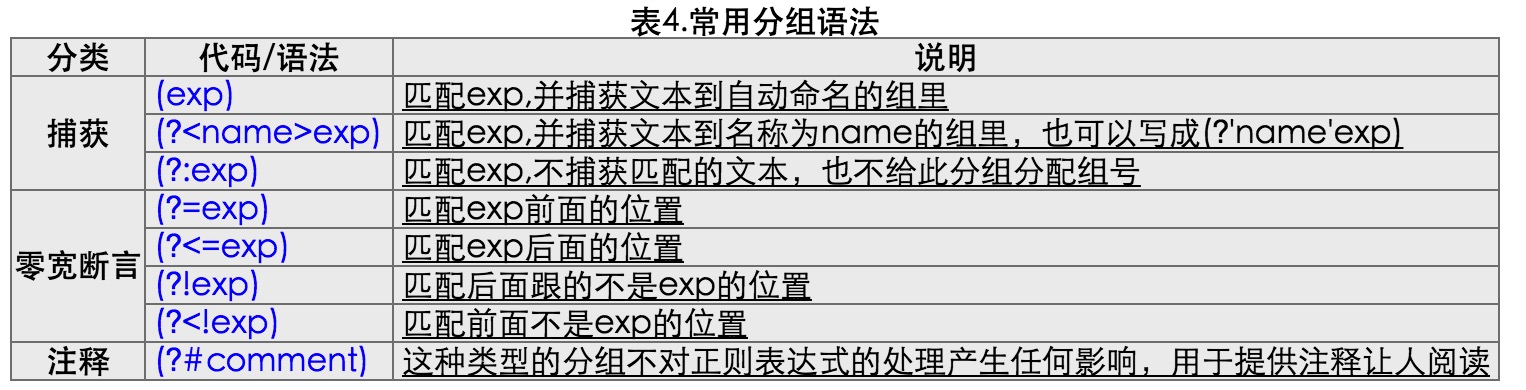
- 后向引用
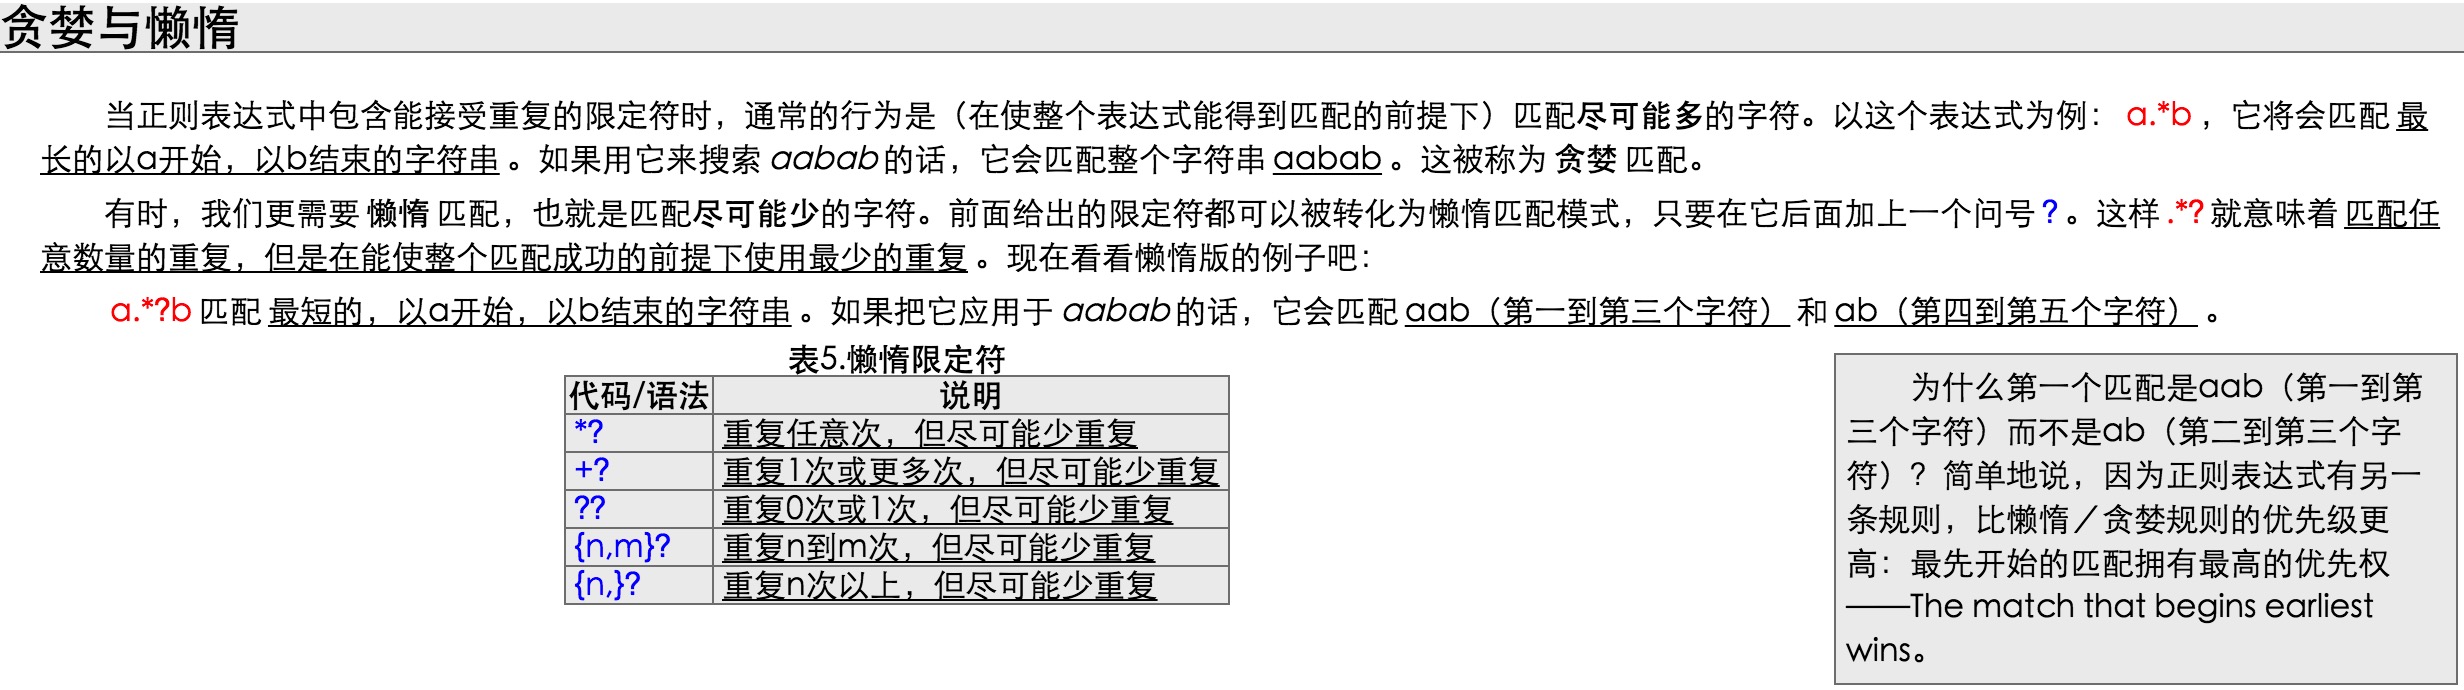
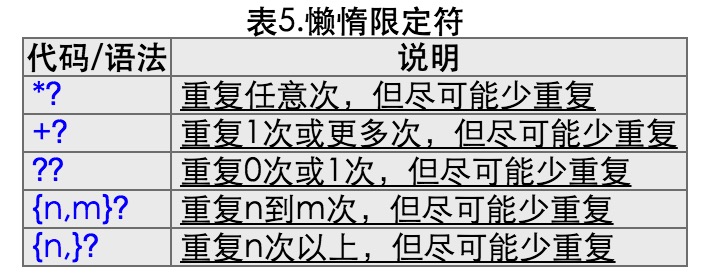
- 贪婪与懒惰
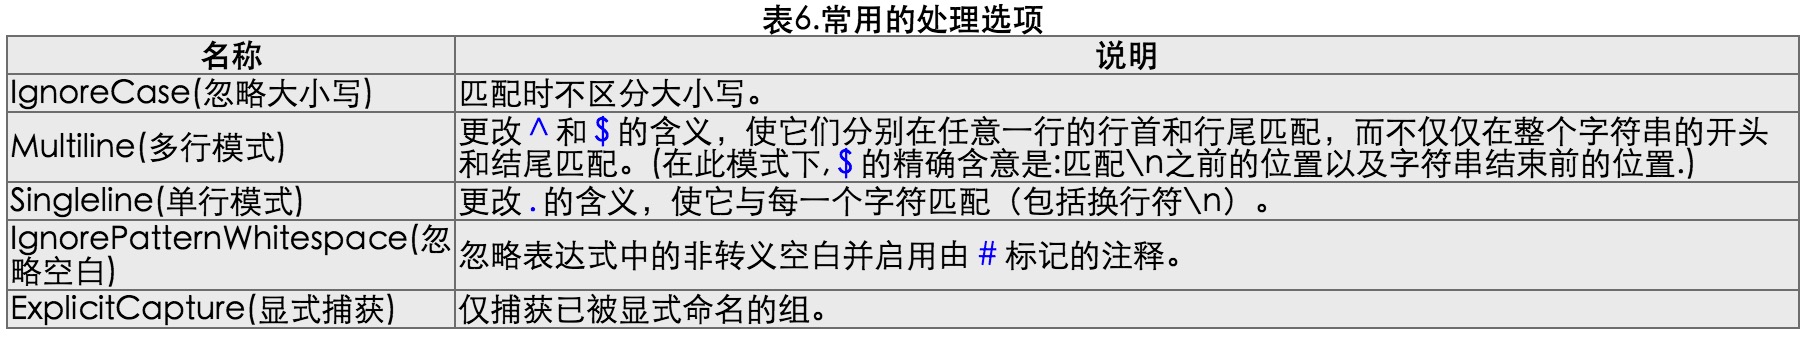
- 常用处理选项
- other
## Linux
### contrab 执行
> 基本格式 : * * * * * command 分 时 日 月 周 命令 第1列表示分钟1~59 每分钟用*或者 */1表示 第2列表示小时1~23(0表示0点) 第3列表示日期1~31 第4列表示月份1~12 第5列标识号星期0~6(0表示星期天) 第6列要运行的命令 crontab文件的一些例子: 30 21 * * * /usr/local/etc/rc.d/lighttpd restart 上面的例子表示每晚的21:30重启apache。 45 4 1,10,22 * * /usr/local/etc/rc.d/lighttpd restart 上面的例子表示每月1、10、22日的4 : 45重启apache。 10 1 * * 6,0 /usr/local/etc/rc.d/lighttpd restart 上面的例子表示每周六、周日的1 : 10重启apache。 0,30 18-23 * * * /usr/local/etc/rc.d/lighttpd restart 上面的例子表示在每天18 : 00至23 : 00之间每隔30分钟重启apache。 0 23 * * 6 /usr/local/etc/rc.d/lighttpd restart 上面的例子表示每星期六的11 : 00 pm重启apache。
- */1 * * * /usr/local/etc/rc.d/lighttpd restart 每一小时重启apache
- 23-7/1 * * * /usr/local/etc/rc.d/lighttpd restart 晚上11点到早上7点之间,每隔一小时重启apache 0 11 4 * mon-wed /usr/local/etc/rc.d/lighttpd restart 每月的4号与每周一到周三的11点重启apache 0 4 1 jan * /usr/local/etc/rc.d/lighttpd restart 一月一号的4点重启apache 名称 : crontab 使用权限 : 所有使用者 使用方式 : crontab file [-u user]-用指定的文件替代目前的crontab。 crontab-[-u user]-用标准输入替代目前的crontab. crontab-1[user]-列出用户目前的crontab. crontab-e[user]-编辑用户目前的crontab. crontab-d[user]-删除用户目前的crontab. crontab-c dir- 指定crontab的目录。 crontab文件的格式:M H D m d cmd. M: 分钟(0-59)。 H:小时(0-23)。 D:天(1-31)。 m: 月(1-12)。 d: 一星期内的天(0~6,0为星期天)。 cmd要运行的程序,程序被送入sh执行,这个shell只有USER,HOME,SHELL这三个环境变量 说明 : crontab 是用来让使用者在固定时间或固定间隔执行程序之用,换句话说,也就是类似使用者的时程表。-u user 是指设定指定 user 的时程表,这个前提是你必须要有其权限(比如说是 root)才能够指定他人的时程表。如果不使用 -u user 的话,就是表示设 定自己的时程表。 参数 : crontab -e : 执行文字编辑器来设定时程表,内定的文字编辑器是 VI,如果你想用别的文字编辑器,则请先设定 VISUAL 环境变数 来指定使用那个文字编辑器(比如说 setenv VISUAL joe) crontab -r : 删除目前的时程表 crontab -l : 列出目前的时程表 crontab file [-u user]-用指定的文件替代目前的crontab。 时程表的格式如下 : f1 f2 f3 f4 f5 program 其中 f1 是表示分钟,f2 表示小时,f3 表示一个月份中的第几日,f4 表示月份,f5 表示一个星期中的第几天。program 表示要执 行的程序。 当 f1 为 * 时表示每分钟都要执行 program,f2 为 * 时表示每小时都要执行程序,其馀类推 当 f1 为 a-b 时表示从第 a 分钟到第 b 分钟这段时间内要执行,f2 为 a-b 时表示从第 a 到第 b 小时都要执行,其馀类推 当 f1 为 */n 时表示每 n 分钟个时间间隔执行一次,f2 为 */n 表示每 n 小时个时间间隔执行一次,其馀类推 当 f1 为 a, b, c,… 时表示第 a, b, c,… 分钟要执行,f2 为 a, b, c,… 时表示第 a, b, c…个小时要执行,其馀类推 使用者也可以将所有的设定先存放在档案 file 中,用 crontab file 的方式来设定时程表。 例子 : #每天早上7点执行一次 /bin/ls : 0 7 * * * /bin/ls 在 12 月内, 每天的早上 6 点到 12 点中,每隔3个小时执行一次 /usr/bin/backup : 0 6-12/3 * 12 * /usr/bin/backup 周一到周五每天下午 5:00 寄一封信给 [email protected] : 0 17 * * 1-5 mail -s “hi” [email protected] < /tmp/maildata 每月每天的午夜 0 点 20 分, 2 点 20 分, 4 点 20 分….执行 echo “haha” 20 0-23/2 * * * echo “haha” 注意 : 当程序在你所指定的时间执行后,系统会寄一封信给你,显示该程序执行的内容,若是你不希望收到这样的信,请在每一行空一格之 后加上 > /dev/null 2>&1 即可 例子2 : #每天早上6点10分 10 6 * * * date #每两个小时 0 */2 * * * date #晚上11点到早上8点之间每两个小时,早上8点 0 23-7/2,8 * * * date #每个月的4号和每个礼拜的礼拜一到礼拜三的早上11点 0 11 4 * mon-wed date #1月份日早上4点 0 4 1 jan * date 范例 $crontab -l 列出用户目前的crontab.
# something else春夏秋冬
前路漫漫,唯有不屈前行
时刻警醒
不要松懈
评论
滚动到评论区时自动载入。